Actualités & Datastories
Datastory #16 – Mieux orienter les contrôles fiscaux des grandes entreprises minières grâce à la datascience

17/11/2025
1. Une analyse-risque peu automatisée et particulièrement chronophage pour les agents
Au sein de la Direction Générale des Impôts (DGI) ivoirienne, la Direction des Enquêtes, du Renseignement et de l’Analyse-risque (DERAR) a pour principales missions de conduire des investigations pour détecter et réprimer les pratiques frauduleuses visant à éluder l’impôt ; et d’optimiser le recouvrement de ressources fiscales. À l’heure où l’économie ivoirienne cherche à se diversifier en exploitant ses ressources minières, la DERAR souhaite porter une attention plus importante aux grandes entreprises de ce secteur en plein essor. Cela concerne particulièrement le secteur aurifère, avec plusieurs gisements dont les réserves dépassent ou avoisinent les 100 tonnes d’or mises à jour ces dernières années. L’exploitation des mines est assurée dans la majorité des cas par des multinationales, pouvant profiter de cette position pour optimiser leurs profits.
La surveillance des entreprises minières n’est pas un sujet récent pour la DERAR. Pour identifier les entreprises à haut risque fiscal, un premier chantier a été conduit en 2019 avec le soutien de l’agence allemande GIZ. Il s’est traduit par le développement d’un outil semi-automatisé sur Excel, intégrant les indicateurs objectivés définis par la direction sur les différents cas de fraude. Celui permettait le recensement des données des états financiers des entreprises du secteur minier. Bien qu’il présentait un atout important pour la DERAR, l’outil est tombé en désuétude car la collecte, la consolidation et l’analyse des données – issues de sources internes et externes à la Direction Générale des Impôts – sont entièrement manuelles.
Afin d’éviter ce travail chronophage pour les agents, l’objectif du déploiement du cas d’usage est de proposer une solution permettant de collecter automatiquement les données internes et externes de la DGI ainsi que l’analyse-risque des contribuables. Ce projet s’inscrit dans la continuité de celui développé en collaboration avec la GIZ qui avait permis à la DERAR de qualifier des premiers indicateurs objectivés relatifs aux différents cas de fraude et d’identifier les sources de données.
2. Automatiser la collecte des données utiles à la construction des indicateurs d’analyse-risque
Avant de commencer le travail sur les données, les équipes DATAGOV ont accompagné les agents de la DERAR dans la redéfinition des indicateurs établis lors du précédent projet. Ceux ci n’avaient pas été réinterrogés du fait de mouvements internes des agents, ayant empêché de préserver la culture autour de l’outil Excel. Une fois qualifiés, les indicateurs ont été priorisés en vue du développement d’un premier prototype d’outil.
Ensuite, les équipes se sont concentrées sur l’identification des sources de données utiles à la construction de ces indicateurs. Certaines données sont détenues par la DERAR, notamment pour les filiales établies en Côte d’Ivoire. Celles-ci ont été collectées afin d’identifier les formats de donnée nécessaire. Par la suite, les équipes ont développé un script Python permettant l’ingestion de ces données dans une solution de datavisualisation. Ce premier outil permet de calculer les indicateurs par contribuable et par exercice comptable.
Par ailleurs, certaines ne sont pas directement accessibles par la DERAR. Il s’agit notamment des données contenues dans les rapports publiés par les sociétés mères des entreprises aurifères. Ces documents sont au format PDF et n’ont pas de structure normalisée, ce qui rend leur exploitation difficile et démultiplie le temps de collecte.
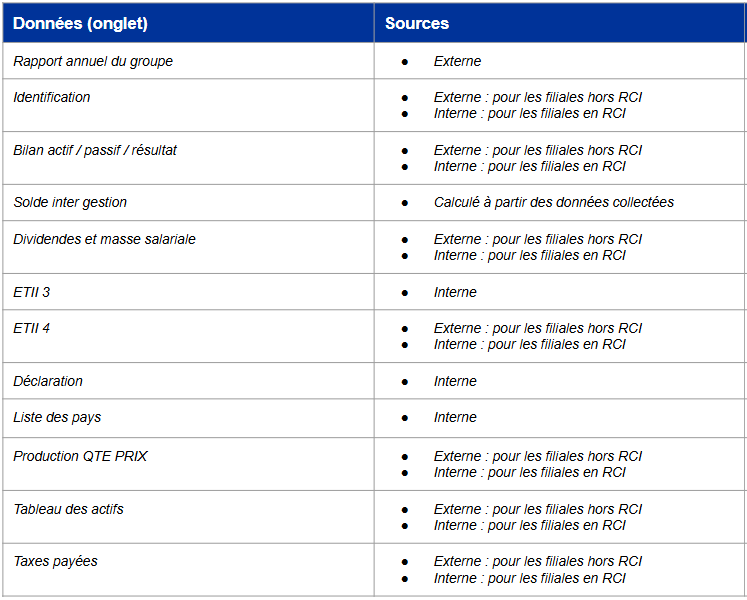
Pour faciliter l’extraction des données nécessaires, les équipes ont utilisé un Visual Language Model (VLM). Celui-ci prend en charge les images en entrée et est en capacité d’interpréter le texte qu’elles contiennent. Les équipes ont configuré des prompts pour que le modèle comprenne quelles sont les données à extraire.
💡Qu’est ce qu’un visual language model ?
Un visual language model (VLM), ou modèle de langage visuel, est une intelligence artificielle qui combine deux types de capacités : la compréhension du langage naturel, comme les modèles de langage classiques ; et l’analyse d’images ou de vidéos grâce à des modèles de vision par ordinateur.
En pratique, un VLM est entraîné simultanément sur des données textuelles et visuelles, de manière à créer une représentation commune (multimodale). Cela lui permet d’interpréter des images, de répondre à des questions sur une image, de générer du texte à partir d’une image, d’associer texte et image et dans certains cas, de générer des images à partir de texte, bien que ce soit souvent réservé aux text-to-image models spécialisés.
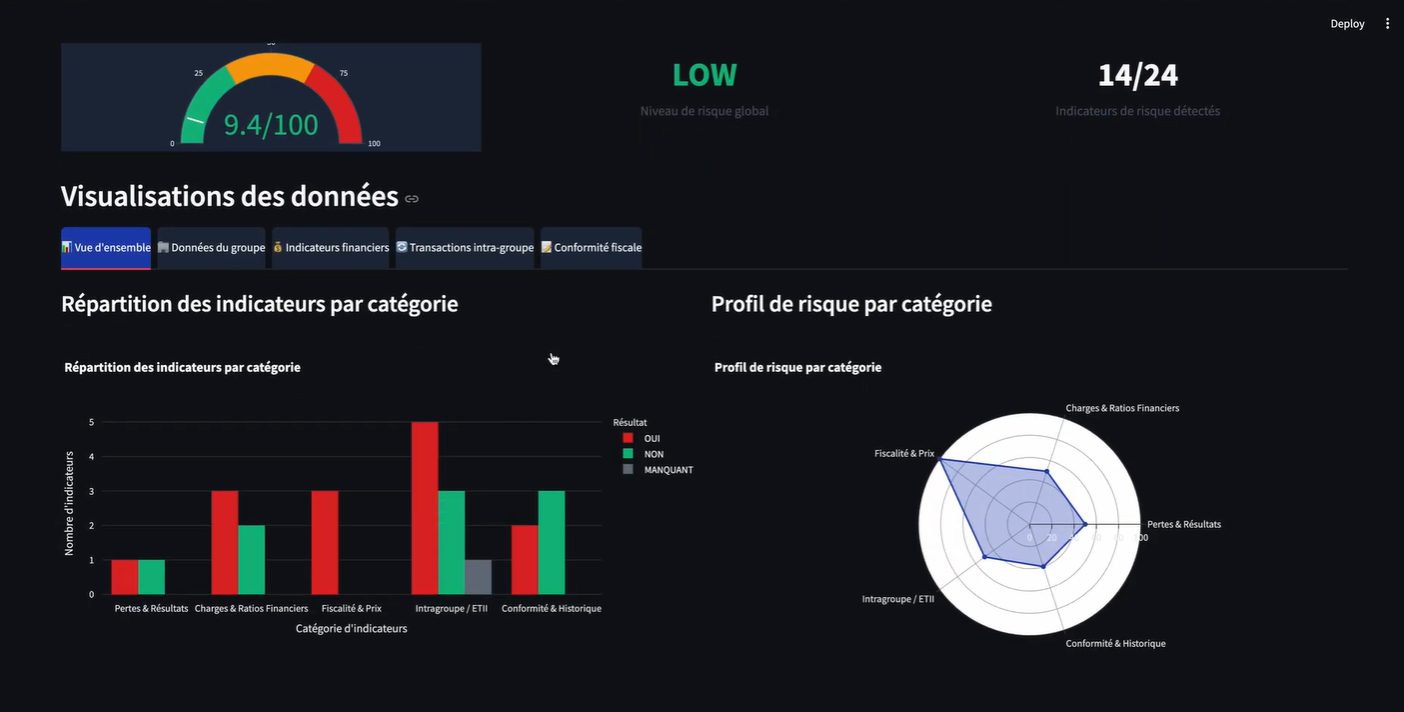
Suite à l’automatisation de la récupération des données, les équipes se sont intéressées à la correspondance entre les données et les indicateurs. La conception de la matrice de correspondance a permis de construire une première version du tableau de bord.
3. Un tableau de bord permettant de faciliter l’orientation des contrôles
La mise en place de la première version du tableau de bord permet tout d’abord aux agent de la DERAR de gagner du temps dans l’analyse des données en évitant notamment une compilation manuelle fastidieuse. Les indicateurs objectivés sont calculés sur la base des données internes et externes, gage d’une amélioration de la détection du risque de fraude. De fait, l’orientation des contrôles appuyée sur la base des 32 indicateurs sera également meilleure.
La DERAR pourra importer de nouvelles données dans l’outil et développer de nouveaux indicateurs. L’équipe DATAGOV a attiré l’attention de la DERAR sur le respect du format standard de données défini par l’équipe d’experts afin de pérenniser l’utilisation de ces nouveaux outils.