Actualités & Datastories
Défi DATAFID 2025 : une deuxième compétition pour mettre la science des données au service des administrations fiscales et douanières

03/06/2025
Une mise en pratique pour une quinzaine de fonctionnaires des impôts et des douanes de 6 pays
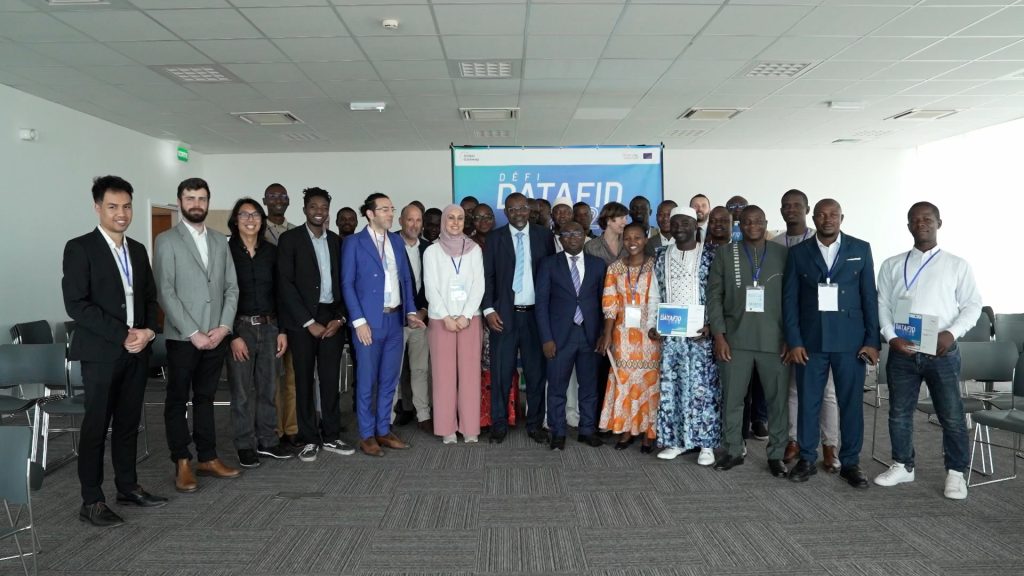
Le Défi DATAFID est le point d’orgue du cycle de formation à la science des données appliquée aux administrations fiscales et douanières, organisé pendant six semaines par l’École nationale de statistiques et d’économie appliquée d’Abidjan (ENSEA), avec l’appui pédagogique de l’Institut de formation continue en économie du développement (IHEDD). Après un appel à candidature lancé à l’automne 2024, et des tests en ligne dans la foulée, une quinzaine de fonctionnaires des impôts et des douanes ont été sélectionnés pour suivre la formation.
Celle-ci s’est déroulée en deux temps :
Un premier temps à distance, avec une série de classes virtuelles étalées sur deux semaines. Les élèves ont suivi trois modules, élaborés dans le cadre du projet DATAFID et mis à jour, leur permettant d’acquérir les connaissances de base sur la science des données (enjeux, état des lieux, origines, utilisation de Tableau, etc.).
Un second temps au sein des locaux de l’ENSEA, étalé sur six semaines, suivant un parcours construit pour assurer une progression hebdomadaire des élèves et leur permettre de faire le lien entre des techniques d’analyse de données et leur métier.
Une mise en pratique pour une quinzaine de fonctionnaires des impôts et des douanes de 6 pays
Le Défi DATAFID est le point d’orgue du cycle de formation à la science des données appliquée aux administrations fiscales et douanières, organisé pendant six semaines par l’École nationale de statistiques et d’économie appliquée d’Abidjan (ENSEA), avec l’appui pédagogique de l’Institut de formation continue en économie du développement (IHEDD). Après un appel à candidature lancé à l’automne 2024, et des tests en ligne dans la foulée, une quinzaine de fonctionnaires des impôts et des douanes ont été sélectionnés pour suivre la formation.
Celle-ci s’est déroulée en deux temps :
- Un premier temps à distance, avec une série de classes virtuelles étalées sur deux semaines. Les élèves ont suivi trois modules, élaborés dans le cadre du projet DATAFID et mis à jour, leur permettant d’acquérir les connaissances de base sur la science des données (enjeux, état des lieux, origines, utilisation de Tableau, etc.).
- Un second temps au sein des locaux de l’ENSEA, étalé sur six semaines, suivant un parcours construit pour assurer une progression hebdomadaire des élèves et leur permettre de faire le lien entre des techniques d’analyse de données et leur métier.
💡Les experts Numéricité acteurs de la formation
François Chastel, datascientist, est intervenu à plusieurs reprises auprès des participants afin de les sensibiliser sur le data engineering, le data processing et l’utilisation de large language model (LLM) dans le processus d’analyse. Il a notamment évoqué la mise en place de systèmes multi-agents (MAS), composés de plusieurs agents d’intelligence artificielle spécifiques. Ceux-ci discutent entre eux pour accomplir des tâches et fournir à l’utilisateur un résultat unique contenant l’ensemble des réponses via l’interface du système global. L’objectif implicite était de faire comprendre aux agents les bons réflexes à avoir dans le développement d’un projet data en administration. Pour en assurer la réussite, il convient avant tout d’identifier les données disponibles, les acteurs à mobiliser et surtout le problème métier à résoudre afin de formuler des hypothèses de solutions pertinentes, et non de réfléchir en termes d’outils ou de solution, comme trop souvent constaté.
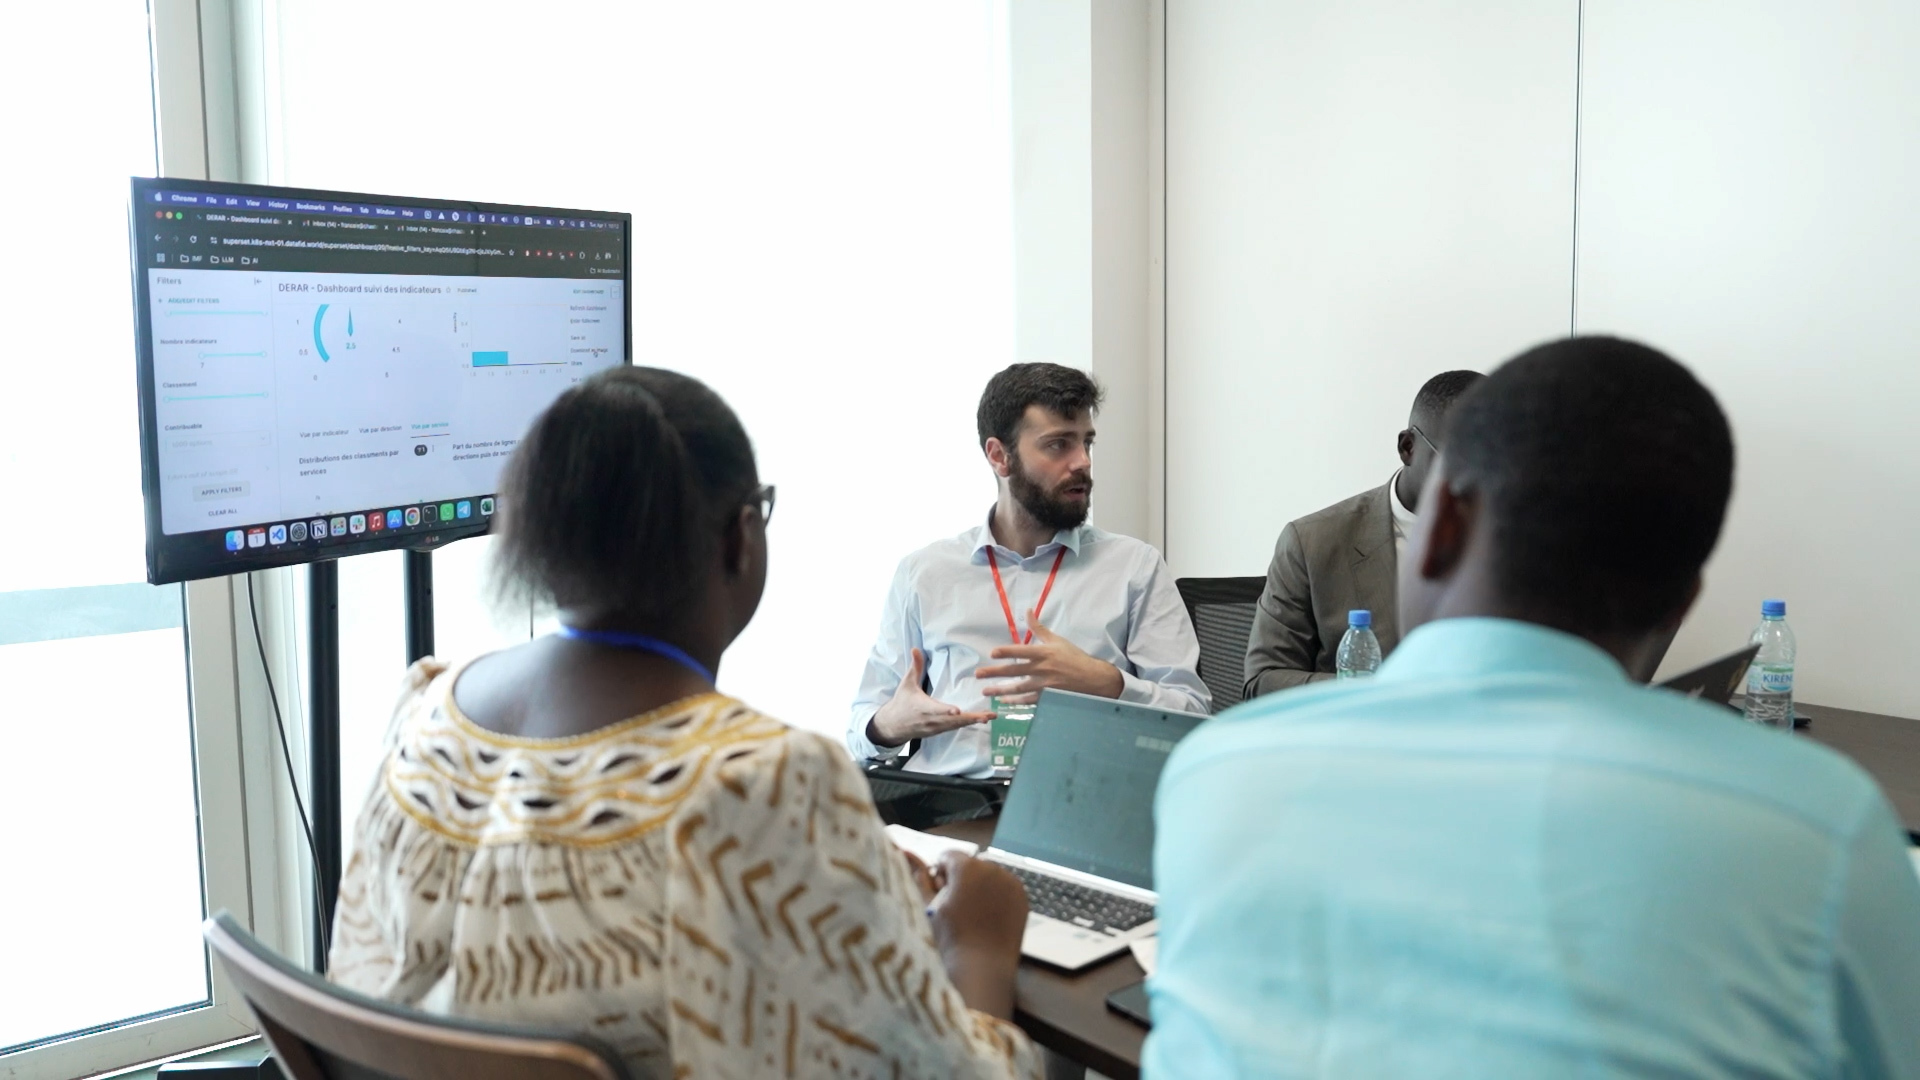
Les participants de la formation ont ainsi eu l’opportunité de s’exercer aux méthodes statistiques univariées, bivariées et multivariées, de méthodes de modélisation et de régression ou encore à celles d’apprentissage supervisé et non supervisé pour la détection des fraudes.
Trois équipes, trois défis, deux jours de travail sur des projets expérimentaux
A l’instar de la première édition, ce nouveau Défi DATAFID était l’occasion pour les participants à la formation de mettre en pratique l’ensemble de connaissances acquises et répondre en équipe à l’un des trois défis proposés par le projet. Cherchant à réutiliser les contenus pédagogiques de la formation, ils se sont appuyés sur les cas d’usage développés par le projet avec les administrations fiscales et douanières de Côte d’Ivoire, du Sénégal et du Bénin. Ces défis font écho à des problèmes régulièrement rencontrés par les agents fiscalistes et douaniers :
- Défi 1 – Automatisation des recettes
La planification budgétaire et la gestion des politiques publiques reposent sur des prévisions financières fiables. Les recettes fiscales et douanières sont influencées par une multitude de facteurs qui rendent leur estimation complexe. Il s’agit de concevoir un modèle prédictif basé sur des techniques de machine learning et l’analyse de séries temporelles pour estimer de manière précise l’évolution des recettes fiscales et douanières
💡Qu’est-ce que le machine learning ?
Le Machine Learning (apprentissage automatique) est une branche de l’intelligence artificielle qui permet aux machines d’apprendre à partir de données, sans être explicitement programmées pour une tâche spécifique. Il s’agit d’entraîner des algorithmes à reconnaître des motifs et à faire des prédictions ou des classifications basées sur ces données.
- Défi 2 – Analyse et établissement des prix de référence des produits à destination de la consommation
Dans un environnement économique en constante évolution, le suivi des prix de référence est crucial. Ces indicateurs influencent les décisions des politiques publiques, mais peuvent servir d’indicateurs de risques. L’objectif de ce défi est de collecter, analyser et prévoir l’évolution des valeurs de référence et des indices de prix à la consommation, servant à la fois pour alimenter les actions d’analyse risque d’un côté et de prévision des recettes de l’autre.
- Défi 3 – Faciliter la classification des produits
Dans le commerce international, la classification précise des produits est essentielle à la bonne application des droits de douane. Traditionnellement, ce processus repose sur des méthodes manuelles, souvent longues et sujettes aux erreurs, et enclines à générer des retards et incohérences dans la tarification. Ce défi cherche à construire une solution intelligente permettant d’assister les agents dans la classification des produits pour la tarification douanière. L’outil pourrait analyser automatiquement les descriptions et caractéristiques des produits et les affecter à des catégories tarifaires précises.
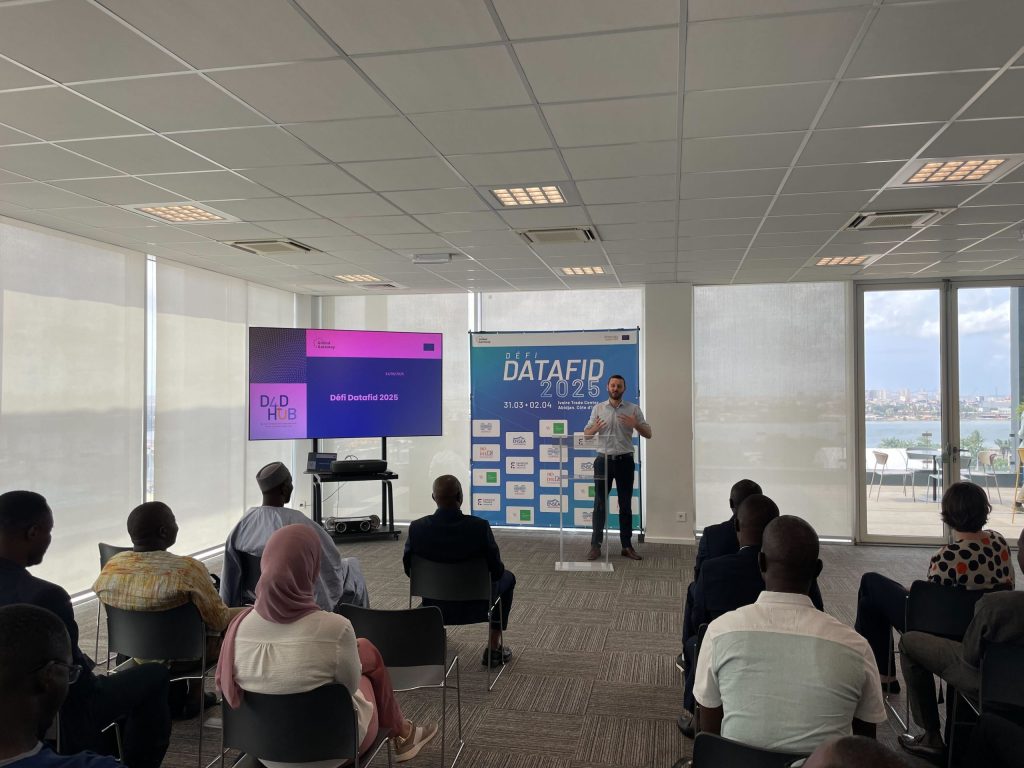
Pour réaliser le travail demandé dans des conditions aussi réelles que possible, les équipes ont pu utiliser des jeux de données réelles, anonymisées, mises à disposition sur le datalab DATAFID :
- Etats financiers d’entreprises sur 5 ans
- Factures des impôts
- Déclarations douanières couvrant la période de 2020 à 2022
- Historique des articles déclarés
- Des données sur le tarif extérieur commun tirées de la base de données de la CEDEAO
Après une présentation des défis et des données disponibles, chaque équipe a choisi le défi qui l’intéressait le plus : la classification des produits pour deux d’entre elles, et la prévision des recettes pour la troisième.
Pour les aiguiller dans leurs travaux, chaque équipe était encadrée par un coach :
- Belle Fille Murorunkwere, Principal Professional chargée des analyses et des statistiques à l’Office des recettes du Rwanda
- Nathan Randriamanana, Data-Scientist à la Direction des statistiques des entreprises à l’INSEE
- Abdel Aziz Kimba, Vérificateur en douanes, spécialiste en data-science
Des coachs transverses étaient également disponibles :
- Henri Ghrissi, Chef du Projet Data mining à la Direction Générale des impôts et des domaines du Sénégal, Expertise France
- Julien Ah-Pine, Professeur à l’Université Lyon 2
- François Chastel, Sam Khouma et Vincent Motte, experts Numéricité
Des projets expérimentaux pour résoudre les problèmes fiscaux et douaniers
Les différents coachs ont invité leurs équipes à adopter un point de vue « métier », c’est-à-dire à s’interroger sur les implications pour les agents, un travail facilité par la diversité des profils représentés (informaticiens, vérificateurs, analystes, statisticiens) et par l’expérience personnelle des coachs. Voici un aperçu des travaux.
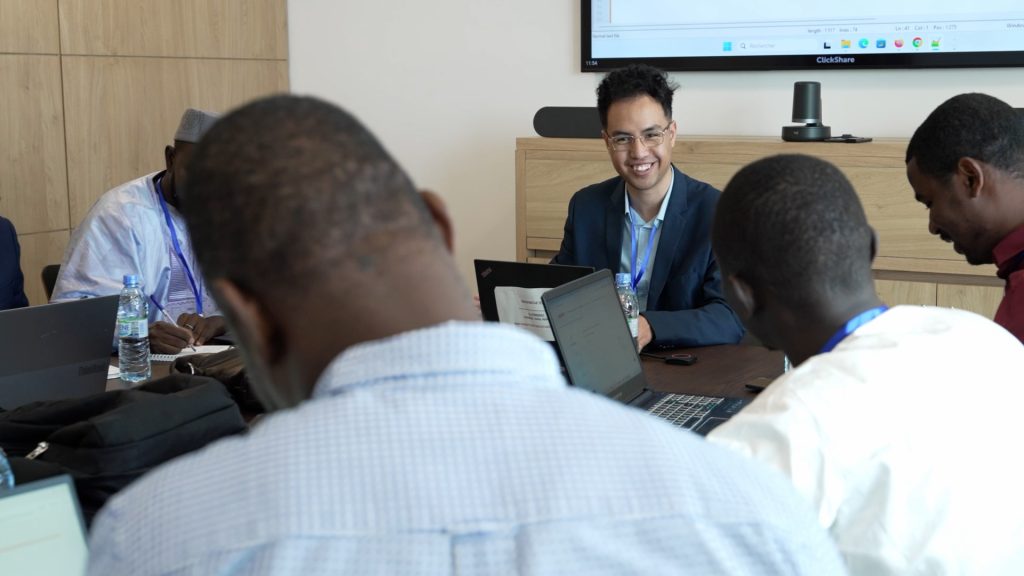
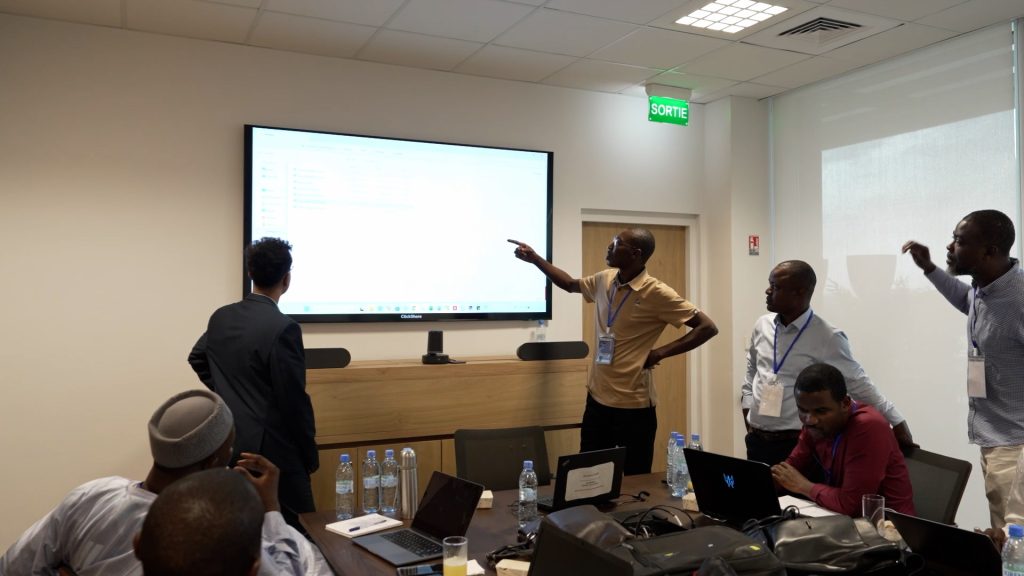
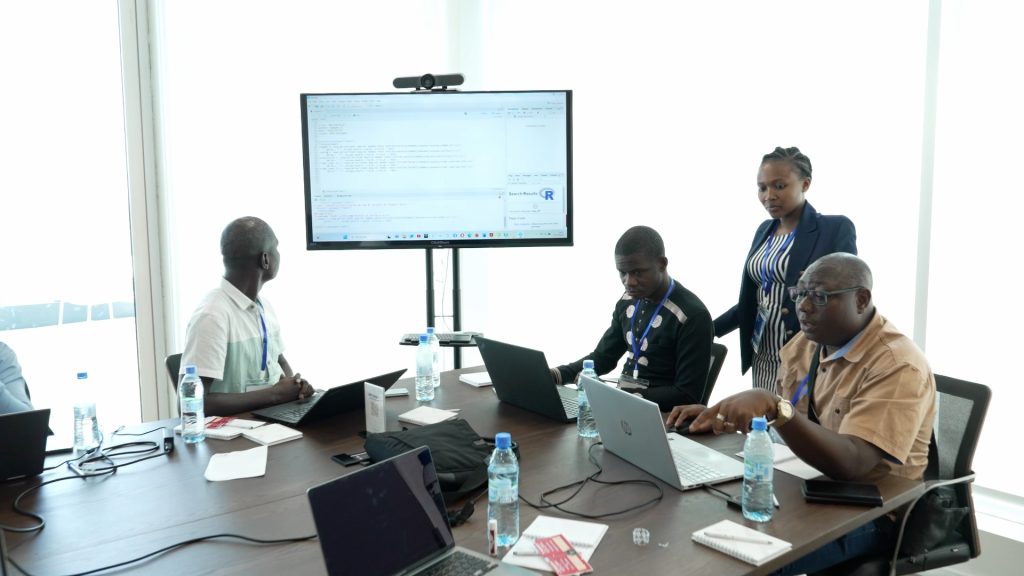
Équipe 1, coachée par Nathan Randriamanana : “Faciliter la classification des produits en déclaration douanière”
À partir de l’historique des déclarations en douanes, de l’historique des articles et des données sur le tarif extérieur commun dans l’espace CEDEAO, le groupe a comparé la performance de deux modèles supervisés : RandomForest et XGBoost. Le recours à ces techniques pour automatiser la classification des produits améliore l’efficacité de l’administration : aide à la priorisation des tâches, amélioration des recettes, et prévention des tentatives de sous-évaluation. Le jury a toutefois souligné certaines limites à la solution proposée avant de pouvoir envisager son déploiement, notamment la nécessité de tester l’application du modèle à d’autres sources de données et d’expérimenter d’autres modèles supervisés.
Équipe 2, coachée par Belle Fille Murorunkwere : “Créer un modèle prédictif de la classification des marchandises en douanes par le machine learning”
Après une analyse exploratoire des données pour détecter les anomalies et les nettoyer, l’équipe a appliqué une méthode d’apprentissage non supervisé (le Natural Langage Processing), pour procéder à la classification des marchandises à partir de leur description. Diverses méthodes d’apprentissage d’apprentissage supervisé (régression logistique, Random Forest, XGBoost) ont ensuite été convoquées. Pour résoudre le défi proposé (la mesure d’impact du glissement tarifaire), c’est la méthode du Random Forest qui a été jugée la plus concluante.
Équipe 3, coachée par Abdel Aziz Kimba : “Automatiser la prévision des recettes douanières”
Le troisième groupe a choisi de travailler sur la prévision des recettes douanières, source de revenus conséquente et dont la qualité détermine la capacité de l’Etat à décider des investissements à mener. Après avoir nettoyé et conduit une analyse exploratoire des données, l’équipe a testé trois modèles (ARIMAX, PROPHET et XGBoost). C’est le modèle ARIMAX qui semble le plus pertinent, le jury encourageant toutefois les membres à intérer à cette expérimentation des variables macro-économiques et à travailler sur une période plus étendue.
L’équipe de Belle Fille Murorunkwere à nouveau lauréate du Défi DATAFID
Après deux jours de travaux, les équipes ont présenté les solutions devant un jury composé de :
- Céline de Quatrebarbes, Directrice du développement et de l’innovation de l’Institut des Hautes Études du Développement Durable, FERDI
- Henri Ghrissi, Chef du Projet Data mining à la Direction Générale des impôts et des domaines du Sénégal, Expertise France
- Julien Ah-Pine, Professeur à l’Université Lyon 2
- Arouna Ndia, statisticien au sein de la Direction Générale des Douanes, République de Côte d’Ivoire
- Matthieu Gonzalez, Chef de projet gestion des finances publiques, Délégation de l’Union européenne en Côte d’Ivoire
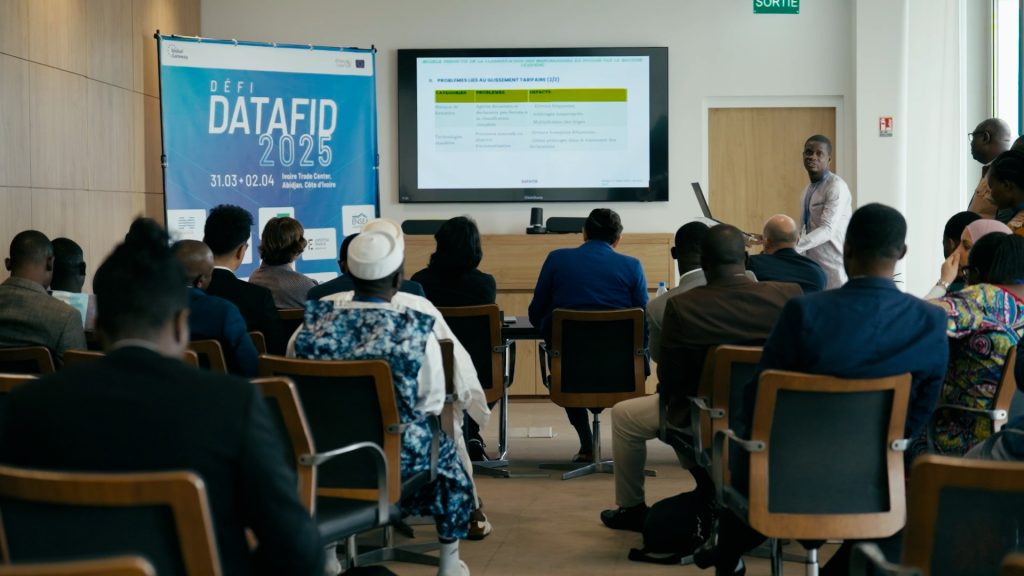
Les propositions ont été évaluées selon six critères
- Travail d’équipe : collaboration et entraide au sein du groupe de travail, prise en compte de la diversité des profils
- Créativité de la solution : approche innovante, capacité à mettre en pratique les résultats
- Pédagogie : capacité à expliquer la solution à divers profils, notamment des profils non-techniques
- Evaluation : évaluation du modèle, évaluation de l’impact métier
- Technique : à quel point la méthode et la technique appliquée est avancée ou adaptée
- Métier : inclusion du métier dans la construction de la solution et suivi des subtilités métiers
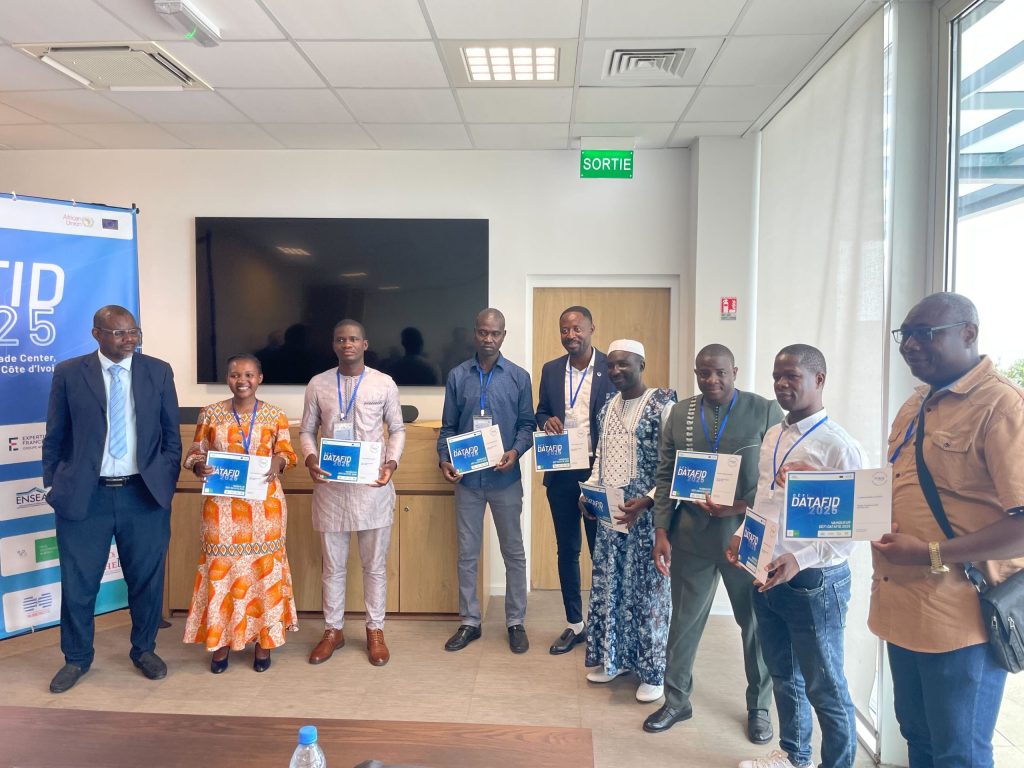
Comme l’année dernière, c’est l’équipe coachée par Belle Fille Murorunkwere qui a remporté le Défi ! Le jury a apprécié la référence à des travaux de recherche pour justifier la pertinence de la solution, la présentation des gains financiers estimés permis par leur modèle, et l’analyse des freins et possibilités du déploiement de la solution dans l’administration. Enfin, le groupe a rappelé que malgré l’intérêt de la méthodologie employée, le recours à l’intelligence artificielle n’est pertinent que si elle apporte une valeur ajoutée évidente par rapport aux pratiques déjà en cours.