Actualités & Datastories
Datastory #10 – Construire l’anonymisation des données fiscales et douanières

26/04/2024
2- Mobiliser plusieurs méthodes d’anonymisation en quelques clics
Pour répondre aux besoins des administrations fiscales et douanières – exploiter, avec confiance, et le plus simplement possible, des données sensibles et stratégiques – l’équipe DATAFID a construit un dispositif permettant de tester et combiner plusieurs méthodes pour aboutir à une anonymisation, mis à disposition sur le datalab DATAFID.
3 approches d’anonymisation possibles
- Approche 1 – La méthode de l’anonymisation “naïve”
Il s’agit d’un premier niveau d’anonymisation qui repose sur la combinaison des techniques suivantes :
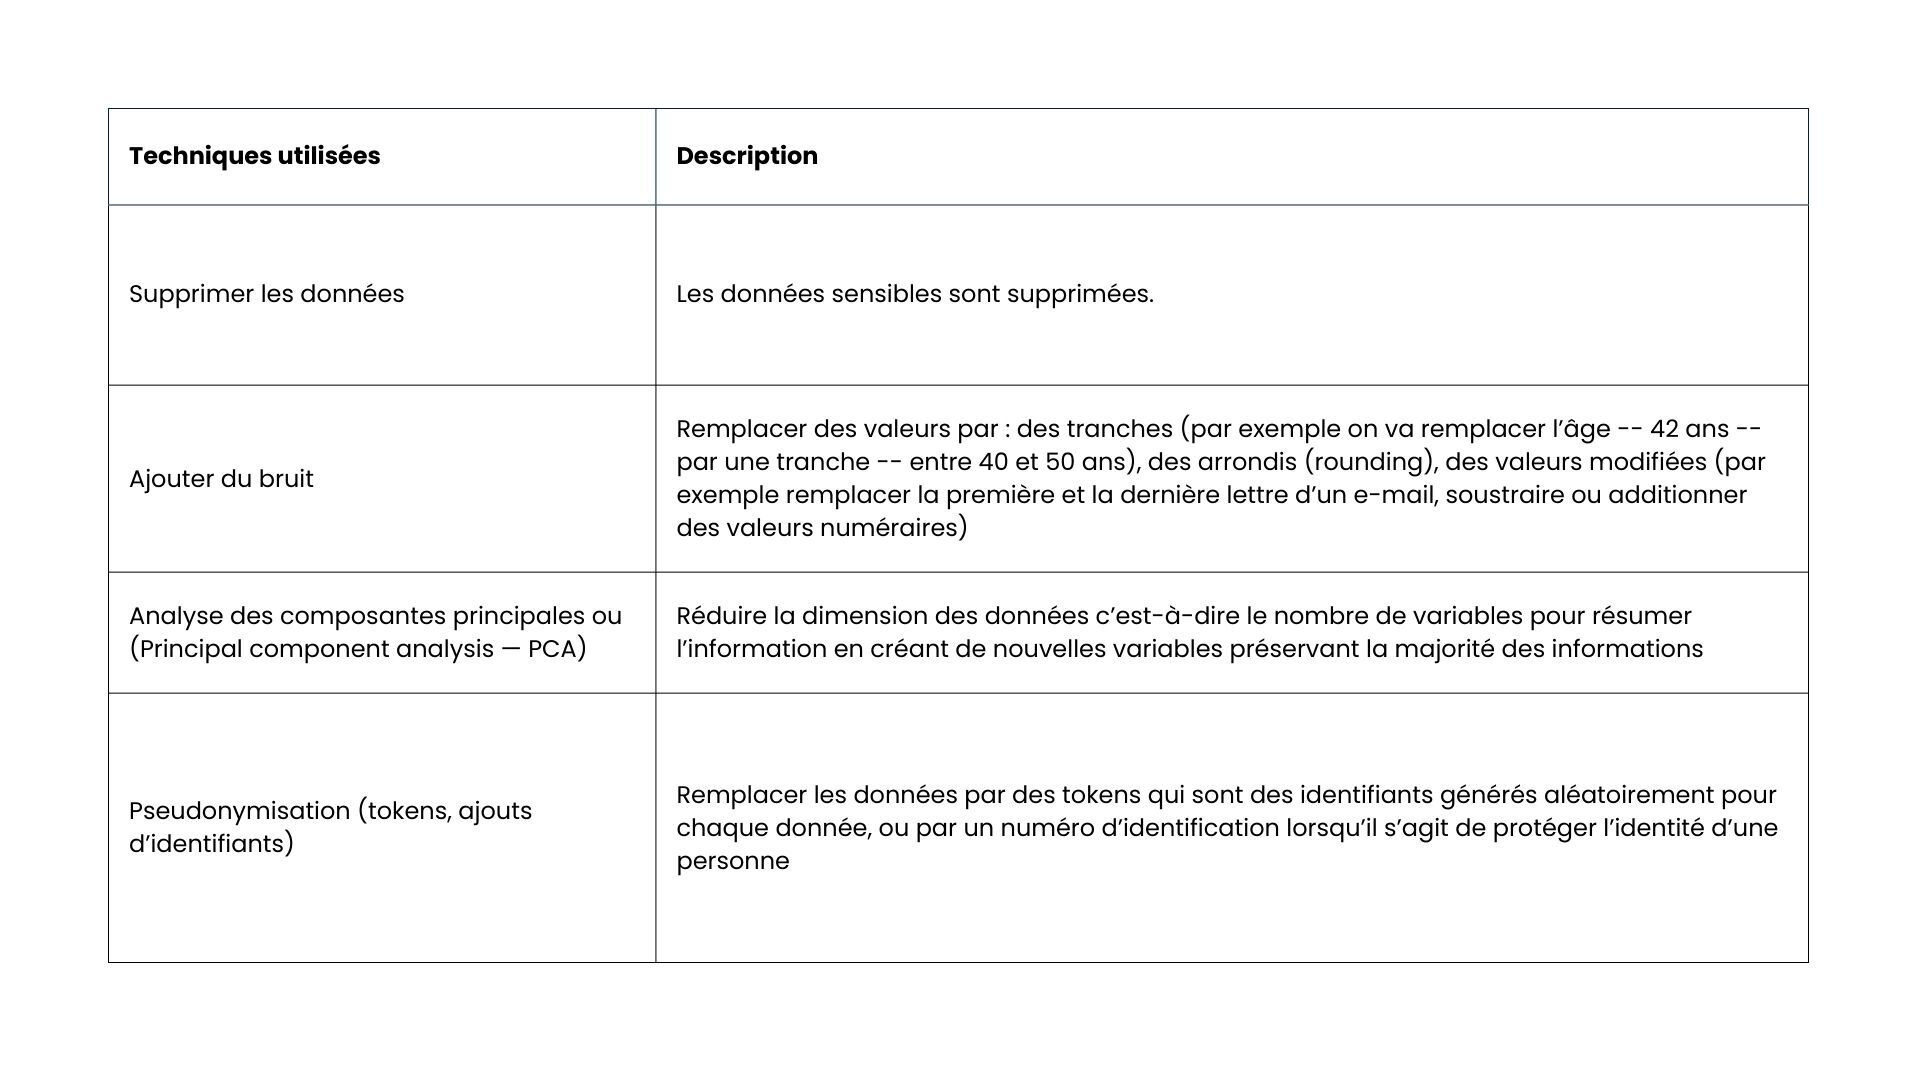
⚙ Dans le cadre des analyses miroirs (datastory sur la sélectivité), des administrations ont retiré les données permettant d’identifier nommément un importateur ou un exportateur. Les informations non-pertinentes pour l’analyse des écarts d’importations et d’exportations ont été modifiées, par exemple : les marchandises ont été classées par type, si l’on prend l’exemple d’un casque audio, cette donnée peut être remplacée par un terme plus englobant, comme “produits audio”.
L’anonymisation naïve est une méthode élémentaire, elle est simple d’utilisation, peu gourmande en ressources — à l’exception de la technique d’Analyse des composantes principales (dites en anglais “PCA”) présentée dans le tableau ci-dessous — et permet de limiter la perte d’informations. En revanche, cette méthode est moins robuste, elle suppose d’opérer davantage de configurations c’est-à-dire qu’elle laisse plus de place à l’utilisateur dans la sélectivité des données devant être supprimées ou modifiées pour permettre une anonymisation. Elle peut supposer de revenir à plusieurs reprises sur le document et d’opérer d’avantage de vérifications “humaines”.
- Approche 2 – La méthode des données synthétiques
La méthode des données synthétiques consiste à alimenter un modèle de machine learning avec des données sources pour qu’il en apprenne les propriétés. Le modèle génère ensuite, de lui-même, de nouvelles données reproduisant les propriétés des données sources. On parle alors de données synthétiques.
La méthode des données synthétiques permet de concilier au mieux l’équilibre entre protection de l’information et qualité des données. Parmi ses avantages : la représentativité des données sources est conservée même avec des données “non réelles”. En revanche, appliquer la méthode des données synthétiques nécessite des ressources importantes et des compétences avancées en datascience. Les équipes DATAFID ont donc réalisé un module permettant de rendre cette méthode la plus accessible possible.
💡 L’équipe DATAFID s’est appuyée sur le réseau bayésien pour concevoir le modèle d’anonymisation.
Généralement représenté sous forme de graphe, le réseau bayésien vise à tenir compte de l’ensemble des variables d’un jeu de données et à établir des liens entre elles à partir des lois de probabilité pouvant être induites. Cette méthode s’oppose à une modélisation qui ne reposerait que sur des lois de probabilité théoriques.
Selon le Laboratoire d’innovation numérique de l’autorité de régulation des données à caractère personnel française (Commission nationale de l’informatique et des libertés), l’avantage de l’utilisation du réseau bayésien repose sur la possibilité de représenter des réalités plus complexes que celles pouvant être issues d’un modèle reposant sur des lois de probabilité théoriques. Cependant, il est possible de remonter aux données sources dès lors que l’on dispose du modèle, puisque la distribution de ces données y est présente.
- Approche 3 – La méthode intermédiaire
A mi-chemin entre l’anonymisation naïve et les données synthétiques, les techniques présentées ici sont largement répandues.
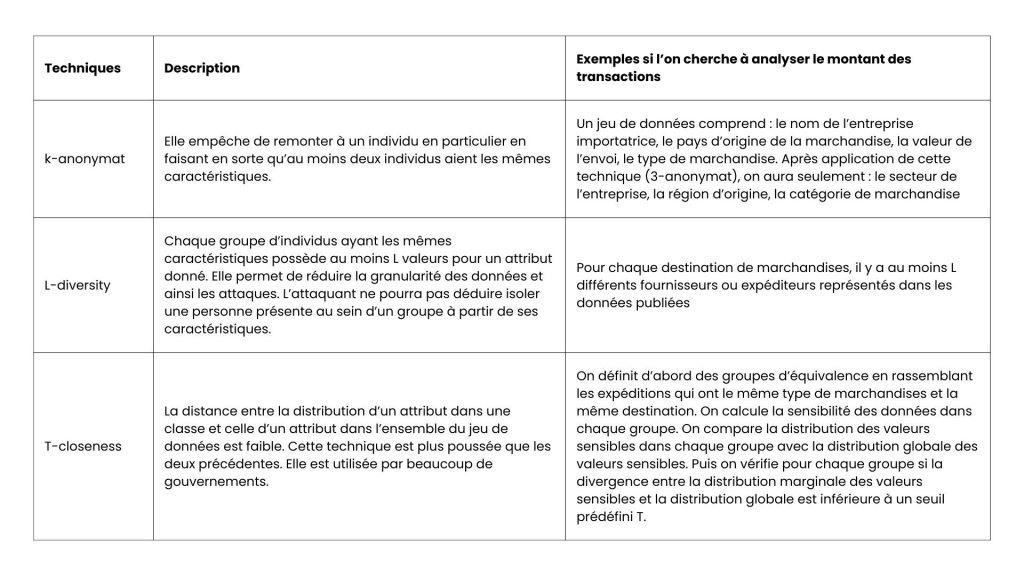
Les avantages de la méthode intermédiaire : moins gourmande en ressource que la méthode synthétique, plus robuste et puissante que la méthode naïve. Elle est en revanche plus difficile à prendre en main.
Proposer un service permettant de tester les méthodes d’anonymisation
Pour faciliter, voire automatiser, l’application de ces méthodes d’anonymisation, un service a été mis à disposition sur le datalab DATAFID.
En déposant un jeu de données, les utilisateurs peuvent visualiser les données et identifier à ce stade les données manifestement sensibles. Delà, il peut choisir plusieurs options : sélectionner une méthode d’anonymisation sur tout ou partie du jeu de données, appliquer une méthode à une ou plusieurs colonnes du jeu de données, appliquer plusieurs méthodes sur un même jeu de données. Le choix de l’approche se fait en fonction de l’objectif poursuivi par l’administration et du type de données présentes. Pour le partage des données avec l’équipe DATAFID, il a été recommandé aux administrations de passer d’abord par l’anonymisation naïve avant de compléter par une autre méthode.
Le service permet ainsi de proposer la panoplie de méthodes existantes actuellement pour anonymiser les données : des plus “basiques” aux plus “poussées. Il a pour atout de permettre de mobiliser et de combiner différentes méthodes d’anonymisation afin de concilier au mieux la préservation du secret et la qualité des données pour pouvoir mener les analyses souhaitées. Cela permet de rappeler qu’il n’y a pas d’anonymisation parfaite mais qu’en utilisant ces méthodes les administrations peuvent créer un maximum de barrières pour empêcher la révélation de certaines informations.
Voir vidéo : Aperçu du service d’anonymisation mis à disposition sur le datalab DATAFID
3- Considérer la valeur de la donnée, un facteur clé dans l’utilisation des méthodes d’anonymisation
Comment les administrations se sont-elles emparées du service d’anonymisation ?
Après quelques semaines de tests, le service a été retiré du datalab DATAFID, car peu utilisé. Ces travaux ont cependant permis de sensibiliser les équipes et mieux qualifier les motivations et freins des administrations à mobiliser des méthodes d’anonymisation dans leur quotidien.
Pour les équipes qui disposent de profils avancés en sciences des données et maîtrisent déjà des techniques pour construire des tableaux de bords, réaliser des suivis d’indicateurs ou piloter leurs activités, la mobilisation de l’anonymisation apparaît comme un accélérateur, un facilitateur. Plus le potentiel et la valeur de la donnée est considéré, plus l’anonymisation est essentielle pour exploiter les données.
Pour les équipes moins avancées en sciences des données, la nécessité de pré-anonymiser les données avant de les déposer sur le datalab a été perçue comme un frein à l’utilisation du service. Parfois c’est le choix de l’approche qui a pu freiner les équipes à utiliser le service.
Pour lever ces freins, plusieurs leviers peuvent être mobilisés comme la formation. Les administrations ont ainsi participé à un atelier sur l’anonymisation dans le cadre du cycle de formations proposé par la Fondation pour les Études et Recherches sur le Développement International (FERDI) fin 2023. Pour autant, ce n’est qu’un début, il faut aller plus loin !
Quelles bonnes pratiques pour assurer la sécurité de son écosystème de données ?
Et pour aller plus loin, et parce qu’il n’y a pas d’anonymisation parfaite, nous vous partageons quelques bonnes pratiques complémentaires pour sécuriser vos données dans le cadre de vos projets :
- chiffrer les données sources et le modèle : l’anonymisation ne protège pas complètement, il peut être possible d’employer des techniques pour remonter aux données sources (par exemple la méthode des données synthétiques). Une approche alternative consisterait à employer des méthodes de chiffrement.
- limiter les accès à ces données et au modèle (par exemple définir un cercle restreint de personnes habilitées à accéder aux données et à ce titre à détenir la clef de chiffrement) ;
- auto-héberger les données et le modèle : l’utilisation d’outils hébergés sur des infrastructures tierces, y compris étrangères, pose là aussi des questions de souveraineté. C’est le cas lorsque Chat GPT est utilisé, puisque la législation américaine (FISA, Cloud act) permet au gouvernement américain d’accéder aux données. Pour limiter ce risque, l’utilisation d’outils auto-hébergés, open source, et présents dans le système d’information de l’organisation même est une alternative à considérer. L’équipe DATAFID travaille d’ailleurs sur le développement d’un modèle souverain auprès d’une administration participant au projet.