Actualités & Datastories
Datastory #9 – L’administration fiscale du Sénégal renforce ses compétences en sciences des données en s’inspirant des méthodes de recrutement des entreprises de la tech

22/04/2024
Alors que les expérimentations suivent leurs cours (voir datastory dédiée), Henri Ghrissi, expert technique international, et pilote du projet Datamining a souhaité recruter une personne experte en sciences des données afin de renforcer ses équipes. Le besoin : recruter rapidement, et surtout, évaluer l’expertise technique des candidats ainsi que leur aptitude à travail au sein d’un environnement gouvernemental.
Comment le processus de recrutement a été conçu, depuis la description du poste jusqu’à la sélection finale ? Quels dispositifs ont été mis en place pour qualifier les candidatures ? Quels enseignements sont à retenir pour des administrations fiscales et douanières ? Comment les équipes DATAFID ont accompagné le recrutement ? Retour en 3 étapes.
Etape 1 – Construire une fiche de poste adaptée au contexte de l’administration
Ce n’est plus un scoop, les experts de la donnée sont une ressources convoitée par toutes les organisations. Cette recherche de talents est d’autant plus complexe pour l’administration, qui n’est pas l’environnement vers lequel se tourne une ou un datascientist en premier lieu, préférant peut être se diriger vers des startups ou des grandes entreprises du numérique. Nombre de programmes publics se multiplient d’ailleurs pour attirer ces expertises, à l’instar du programme Entrepreneurs d’intérêt général en France.
Le recrutement est aussi un investissement pour l’administration. Il s’agit aussi de s’assurer d’une intégration rapide dans l’administration et détecter ainsi l’appétence des candidats à mobiliser ses compétences au service d’un métier complexe, et communiquer avec une diversité d’agents publics, au sein de l’équipe opérationnelle et auprès de décideurs.
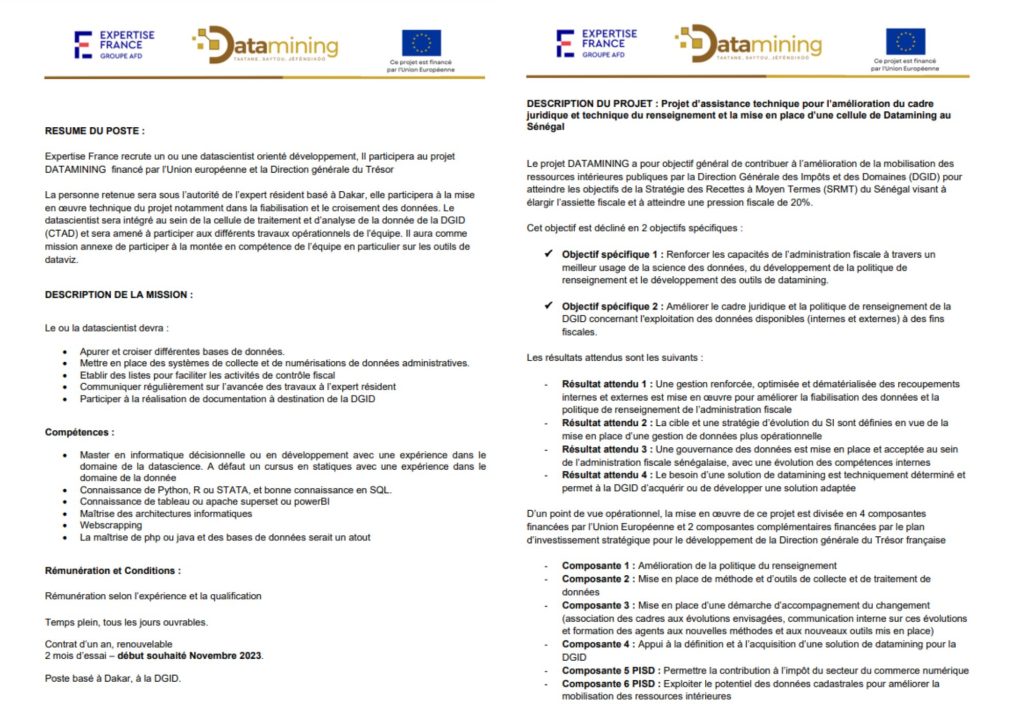
Pour relever ce défi, Henri Ghrissi, chef du projet Datamining, a mis ses équipes à contribution pour rédiger une fiche de poste qui décrive succinctement les compétences techniques requises, et insiste davantage sur le sens de la mission. Parmi les éléments remarquables, la fiche de poste souligne le fait que le candidat retenu devra non seulement installer des systèmes de collecte, croisement et analyse de données, mais participer à des missions davantage tournée vers le métier : contribuer à l’orientation des activités du contrôle fiscal, communiquer régulièrement sur les résultats du projet et documenter le projet. En somme, on ne fait pas des commandes d’analyse de données au datascientist, mais on l’intègre pleinement dans la transformation des activités de l’administration fiscale.
Etape 2 – Développer un dispositif d’évaluation sur mesure et de haut niveau
Le dispositif de sélection a été conçu en partenariat avec Pape Ngal Diao, représentant de Databeez, EdTech panafricaine, et François Chastel, datascientist du projet DATAFID, qui a éprouvé les méthodes de recrutement de grandes entreprises du numérique.
Pour apprécier rigoureusement les aptitudes techniques, analytiques et relationnelles des postulants, trois étapes ont été proposées, chacune avec des critères et un barème pré-établis :
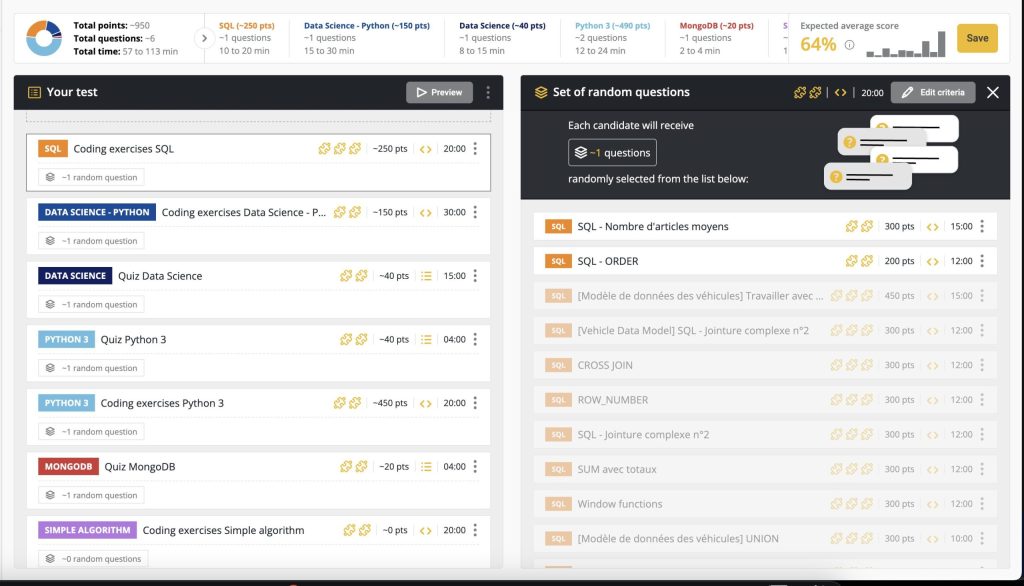
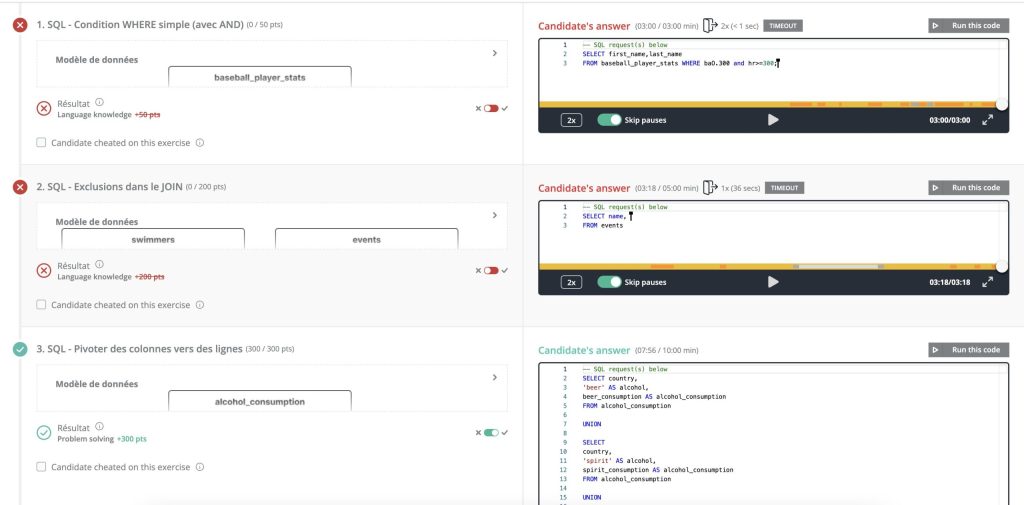
1) Un test en ligne : faisant office de premier “filtrage”, il s’agit d’évaluer les connaissances fondamentales des candidats et leur capacité à les appliquer sur des “petits” problèmes pratiques, via des questions à choix multiples ou ouvertes. Les cas pratiques permettent de pré-évaluer les compétences en statistiques, programmation et machine learning.
- La plateforme utilisée pour le test permet d’assigner les questions de manière aléatoires et d’enregistrer les actions des candidats, le temps passé par exercice, et les différentes étapes pour résoudre le problème.
- Le barème cumule 2570 points répartis selon les différentes étapes et le temps maximum pour le réaliser est établi à 120 minutes
2) Un cas de datascience “réel” : conçu pour évaluer la capacité à traiter des problématiques métier, les candidats sont invités à travailler sur un projet réel, impliquant l’analyse de données, la création de modèles prédictifs, le clustering et la visualisation des résultats.
- Le cas proposé est commun à l’ensemble des candidats. A partir d’un jeu de données sur la taxation américaine, les candidats sont invités à réaliser plusieurs analyses. Première analyse, plutôt descriptive : caractériser le jeu de données (aperçu statistique, description des catégories, vérification de données manquantes, corrélations). Les questions suivantes appellent les candidats à réaliser des distributions basiques (ex : âge par rapport au montant du revenu imposable) et des segmentations. Enfin, les candidats doivent mettre en œuvre un modèle prédictif pour identifier des contribuables qui ont déclaré un revenu inférieur à un montant mais présentent des caractéristiques similaires à ceux qui ont déclaré au-dessus. Une première invitation à s’intéresser à l’analyse risque en fiscalité !
- Les réponses des candidats sont évaluées 2 fois. Une première grille (Databeez) fonde ses critères de notation sur les étapes du cas pratique (exemples de critères : compréhension de la demande, capacités d’analyse, compétences dans le choix des modes de visualisation et du modèle, qualité du code et documentation). Une seconde grille (Datafid/Numéricité) analyse les réponses de manière transversale (exemples de critères : rigueur scientifique, créativité dans le choix des modèles, efficacité des techniques d’optimisation, clarté de la communication écrite, reproductibilité du code)
3) Un entretien en présentiel : dernière étape du processus, l’objectif est d’évaluer des compétences techniques pointues des candidats ainsi que leur capacité à communiquer efficacement sur des sujets complexe
- L’entretien se déroule avec les 2 datascientists qui ont conçu les tests en ligne et le cas pratique. Après s’être présenté, le candidat échange avec le panel sur les tests réalisés, puis des questions plus approfondies lui sont posées. Quelques exemples de questions ouvertes permettant l’échange interactif : expliquez le fonctionnement d’un réseau de neurones, expliquez les résultats de votre rendu, expliquez une méthode de suivi de la performance de votre modèle.
- 4 critères d’évaluation permettent de classer les candidats : expertise technique, capacité de résolution de problèmes, communication, collaboration et travail d’équipe. Encore une fois, les “soft skills” ont autant leur place que les compétences techniques !
Etape 3 – Sélectionner les candidats !
Après un mois de diffusion de la fiche de poste,300 candidatures ont été reçues, le premier tri réalisé en amont par henri Ghrissi et son équipe a permis de retenir les 70 candidats avec une expérience même minime en datascience Parmi ces candidatures, aucun tri n’a été effectué. Tous les candidats du junior à l’expert chevronné avaient leur chances . Le processus de sélection décrit plus haut a donc pu démarrer !
Les 70 candidats ont mené le test en ligne, et nos 2 recruteurs ont ensuite évalué l’ensemble des candidats, ce qui représentent environ 1000 réponses ! Une analyse fine a été réalisée : d’abord évaluer la justesse de la réponse, ensuite affiner en regardant si la réponse est partiellement bonne ou absente par manque de temps (ce qui induit que le candidat était proche).
A l’issue du test en ligne, 10 candidats ont été retenus pour réaliser l’exercice du cas réel. Les réponses ont encore une fois été analysées deux fois, un classement a été réalisé pour sélectionner les 5 premiers candidats pour l’étape finale.
Les entretiens en présentiel terminés, 3 candidats ont été proposés à Henri Grhissi, chef de projet Datamining, qui les a rencontrés individuellement avant de partager sa décision !
Ces différentes étapes ont été menées très rapidement : la sélection du candidat s’est réalisée en moins d’un mois. Il intègrera la DGID au début du mois de mai.
Henri Ghrissi, chef du projet Datamining, témoigne : “Le processus de recrutement a été particulièrement efficace pour gérer plus de 70 candidatures. Intégrer des tests techniques objectifs dès les premières étapes a permis d’évaluer les candidats sur leurs compétences effectives, et pas uniquement sur leurs diplômes. Le profil recherché était à la croisée entre le datascientist et le data ingénieur, et cette méthode nous a permis d’identifier le candidat le plus en adéquation/pertinent avec les besoins métiers. Enfin, la disponibilité de François et sa compréhension précise des enjeux de recrutement nous ont permis de mettre en place ce processus de manière rapide et d’optimiser l’efficacité opérationnelle.”
Dans l’ensemble, les candidatures furent d’un très bon niveau. D’après les recruteurs, “les 3 candidats pré-sélectionnés après les entretiens peuvent prétendre à un poste dans une grande entreprise du numérique”. Par ailleurs, certaines candidatures ont été partagées par l’expert à des homologues dans la sous-région et d’autres projets menés par EF qui pourraient avoir prochainement besoin de compétences en datascience, participant à la constitution d’un potentiel vivier de talents.
Quelles bonnes pratiques pour recruter des talents de la donnée dans des administrations fiscales et douanières ?
D’après François Chastel, pour recruter des compétences en sciences des données “Le titre n’est pas important, c’est savoir ce qu’il va faire dans le réel qui compte”. Il nous partage ainsi quelques conseils :
- Déterminer clairement le périmètre des responsabilités, le poste doit être clair, on doit connaître les principales tâches requises ainsi que l’environnement technique de l’administration. Il est important d’être transparent pour éviter d’éventuelles frustrations.
- Décrire en détail les “subtilités” opérationnelles : le métier de l’administration d’accueil doit être présenté de manière transparente, ainsi que les objectifs en matière de transformation par la donnée
- Définir les attentes en matière de posture (et de soft skills): cherche-t-on un profil “leader” ou exécutant ? a-t-on besoin de créativité, de rigueur, de communication ?
- Transformer ses ressources humaines : parmi les stratégies gagnantes, se doter d’équipes RH qui ont déjà évolué dans des organisations du numériques, élaborer des parcours de recrutement alternatifs (recruter des stagiaires en pré-embauche, organiser des concours type Kaggle), et être présent dans les universités pour valoriser auprès de jeunes talents les atouts de l’administration !