Actualités & Datastories
Défi Datafid 2023 : à Abidjan, un hackathon pour révéler le potentiel des données fiscales et douanières

12/04/2024
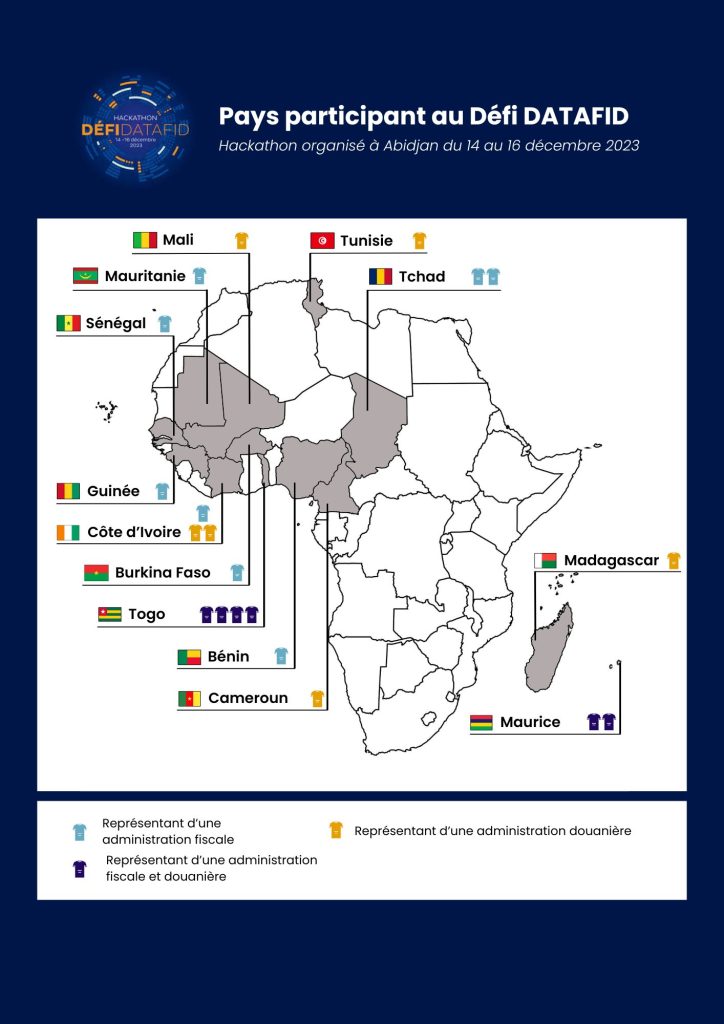
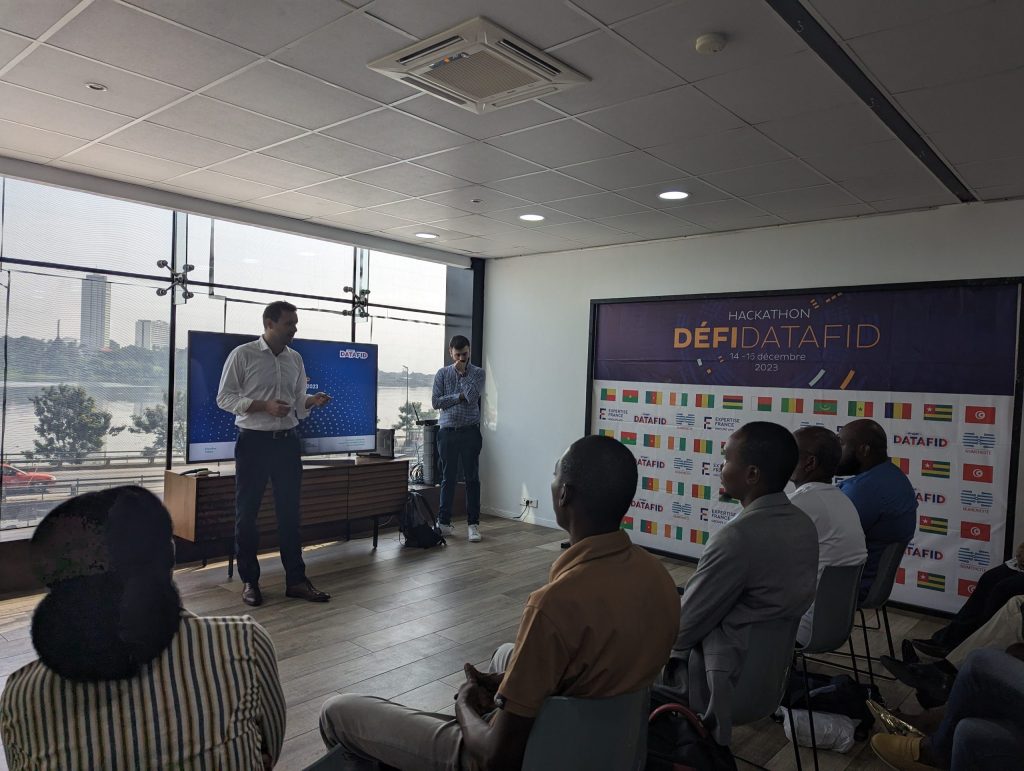
Le terrain et les règles du jeu : 4 défis, 10 jeux de données et une équipe de coachs
Pour construire le défi Datafid, une équipe d’experts de Numéricité a préparé le terrain pendant 6 mois. En s’appuyant sur les modules de la formation menée à l’ENSEA, l’expérience des 4 pays du projet DATAFID – Côte d’Ivoire, Togo, Mauritanie et Niger – qui depuis 2 ans explorent des cas d’usage de données fiscales et douanières dans leurs administrations, et la connaissance de plus en plus des données, 4 défis thématiques ont été conçus :
- Défi 1 – Analyse risque : comment exploiter tout le potentiel des données historiques afin d’améliorer l’assignation des contrôles ?
- Défi 2 – Valeur : comment identifier les sous-évaluations et sur-évaluations des déclarations (valeurs pour les douanes / analyses pour les déclarations fiscales) ?
- Défi 3 – Mieux comprendre les usagers (profiling) : comment améliorer la connaissance des usagers à travers une meilleure utilisation des données ?
- Défi 4 – Gestion calendaire : comment améliorer l’assignation des contrôles afin d’optimiser les résultats des contrôleurs dans un contexte RH contraint ?
Un projet data est rarement académique. C’est pour cela que les questions posées par les défis étaient volontairement ouvertes, pour laisser la liberté aux équipes d’approcher les questions métiers selon leur connaissance du terrain.
Pas de match sans terrain de jeu ni sans ballon, pas de hackathon sans infrastructure de données u0021
Et pour cela, les participants ont eu accès au datalab Datafid, sur lequel des jeux de données de tests ont été mis à disposition pour être le plus proche possible des conditions réelles.
- Données de déclarations de TVA et de chiffres d’affaires
- Données de transactions douanières (type Sydonia)
- Des données en open data ont également été répertoriées et préparées par l’équipe, notamment les données de Comtrade et du Global Company Registry (registre public des grandes entreprises multinationales)
Pour en savoir plus sur le datalab : https://datalab.datafid.world/article/datastory_infrastructure_opensource
Au lancement du hackathon, l’équipe d’animation du défi a présenté les défis, les données disponibles et a annoncé la composition des 4 groupes. Le parti pris : mixer les expertises métier et les pays, pour encore plus de partage de compétences et de collaboration u0021 Les groupes ont eu la liberté de choisir le défi sur lequel travailler : 3 groupes ont choisi de s’intéresser à la valeur (défi 2), et un groupe a choisi le défi sur l’affectation RH (défi 4).
Pour stimuler et accompagner le travail des groupes pendant les 3 jours de compétition, une équipe de coachs a été constituée.
⚽ L’équipe d’accompagnement internationale du défi Datafid
Coachs par équipe :
- Belle Fille Murorunkwere, Principal Professional chargée des analyses et des statistiques Office des recettes du Rwanda
- Nathan Randriamanana, Data-Scientist à la Direction des statistiques des entreprises à l’INSEE (France)
- Sadikh Dieye, Ingénieur statisticien économiste, Responsable de la cellule des traitements et analyses de la donnée Direction générale des impôts et des domaines du Sénégal
- Abdelaziz Kimba, Vérificateur en douanes, spécialiste en data-science
Coachs transverses :
- Julien Ah-Pine, Professeur à l’Université Lyon 2
- Henri Ghrissi, Chef du Projet Data mining à la Direction Générale des impôts et des domaines du Sénégal, Expertise France
- Equipe Numéricité/FERDI : François Chastel, Yoann Le Bars, Céline de Quatrebarbes, Thomas Menant, Vincent Motte
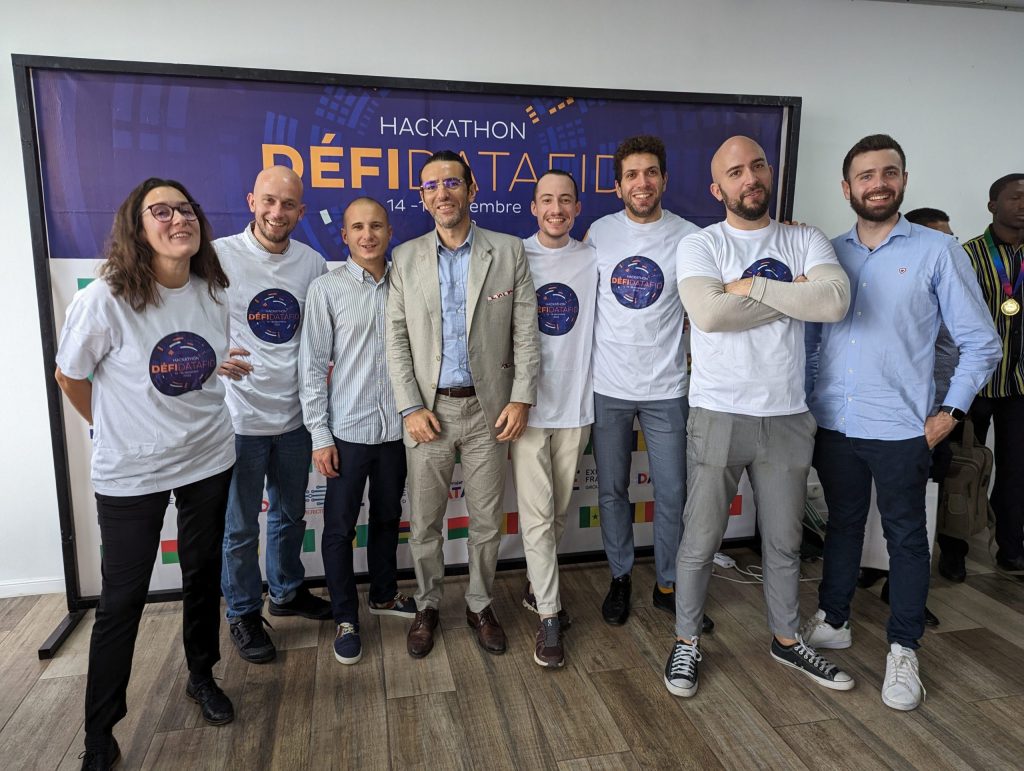
Et pour s’assurer d’une compétition dans les règles de l’art, un jury a été constitué pour sélectionner le défi qui mérite la “coupe Datafid”
⚽ Les membres jury du défi Datafid
- Henri Ghrissi, Expertise France – Datamining Sénégal
- Thomas Menant, Numéricité
- Arouna N’Dia, Direction générale des douanes, République de Côte d’Ivoire
- Don Jean Stéphane Soumahoro, journaliste indépendant
- Céline de Quatrebarbes, Fondation pour les études et recherches sur le développement international
La compétition vue par les coachs
Prendre du recul sur les enjeux techniques pour s’intéresser à l’impact métier
Pendant les premières heures de travail, les coachs ont invité les groupes à approcher leur défi du point de vue du métier. Belle Fille Murorunkwere, a permis à son groupe de prendre du recul : “après avoir choisi leur défi, mon groupe voulait partir bille en tête sur les données mais je les ai invités à clairement définir ce que signifiait la sous-évaluation en douane avant d’identifier les étapes techniques”.
La constitution des groupes était propice à l’approfondissement des contextes métier : par exemple, quand les spécialistes des douanes décrivent leurs manières de qualifier des anomalies de valeurs sur des déclarations, les fiscalistes peuvent partager leurs modèles d’analyse-risque. Ces échanges d’expérience ont aussi été apportés par les coachs. Kimba a partagé son expérience à son groupe : “j’ai témoigné sur le travail réalisé au Niger sur l’analyse de la performance et leur spécialisation, cela a permis à mon groupe d’avoir une meilleure vision des indicateurs à concevoir pour optimiser l’affectation des vérificateurs en douane”.
La mobilisation d’outils d’analyse de données
Partant d’une vision plus fine des résultats à analyser pour répondre au problème métier, les groupes ont mobilisé des techniques de sciences de données non seulement pour réaliser des traitements sur les données (nettoyage, labellisation, classification) et les analyser à l’aide de modèles plus ou moins avancés. Même si les données utilisées et problématiques d’entrée ont pu varier, tous les groupes se sont tournées vers la sélectivité pour résoudre les défis.
Quelques exemples de réalisations :
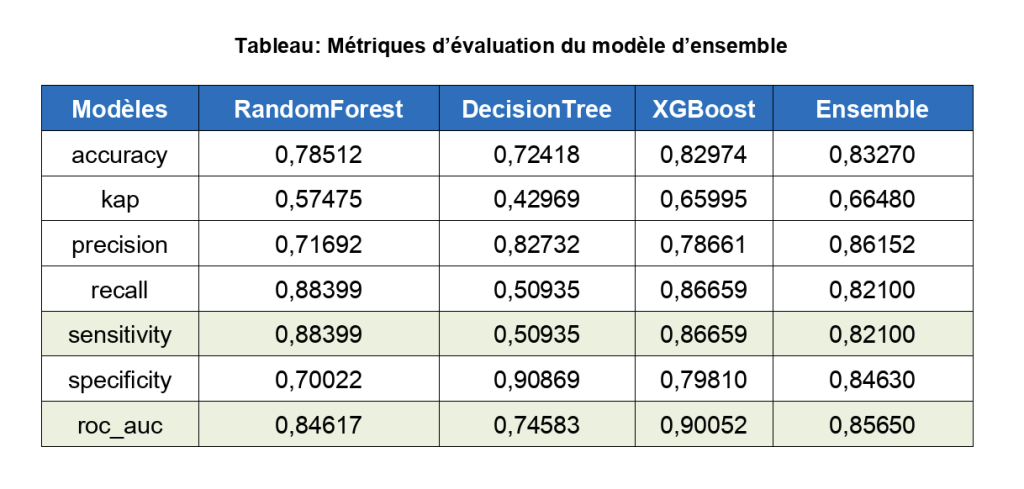
- Groupe 1 : à partir des données douanières, le groupe a comparé la performance relative de 2 modèles supervisés (RandomForest et XGBoost) et d’un modèle non supervisé (Classification Ascendante Hiérarchique) pour détecter des fraudes de sous évaluation. La conclusion : la combinaison de l’apprentissage supervisé et non supervisé permet d’attendre des résultats précis et ainsi aider à l’optimisation des processus douaniers pour cibler plus rapidement les cas suspects.
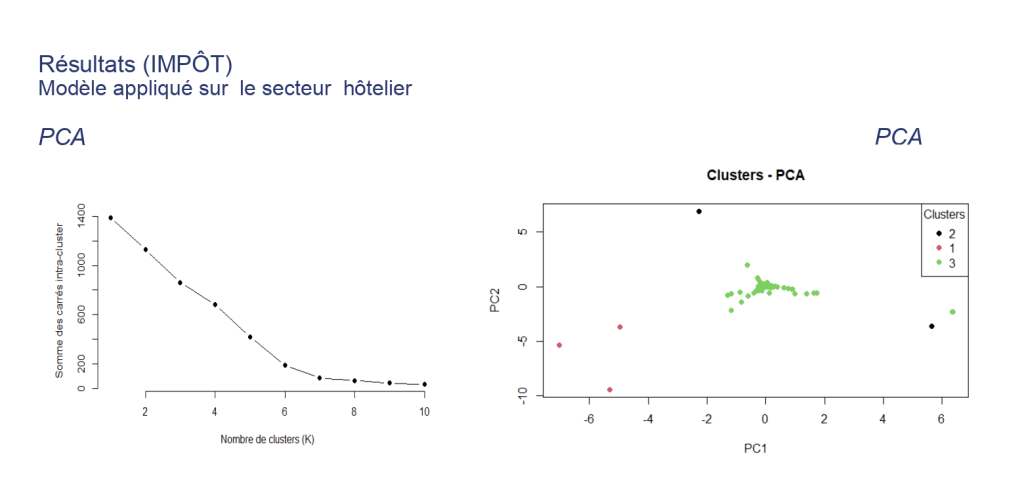
- Groupe 2 : A partir de données d’états financiers d’entreprises, le groupe a aussi combiné plusieurs méthodes de détection d’anomalie (K-means, l’analyse en composantes principales, DBSCAN pour “density-based clustering non-parametric algorithm”) pour détecter de déclarations frauduleuses dans un secteur donné. “Le groupe a également mis en place une application R-Shiny pour prédire le comportement frauduleux des déclarations en douanes à des fins de vérifications”, mentionne Sadikh Dieye, coach du groupe 2.
- Groupe 3 : à partir de données douanières ainsi que des données sur les tarifs extérieur de l’espace CEDEAO, le groupe a identifié les facteurs qui contribuent à la sous-évaluation en douane, permettant de sélectionner les variables à analyser. Les données ont ensuite été entraînées sur un modèle XGBOOST, dont la performance a été évaluée. Le résultat : plus de 95% des déclarations faisant l’objet de sous-évaluation sont interceptées par le modèle.
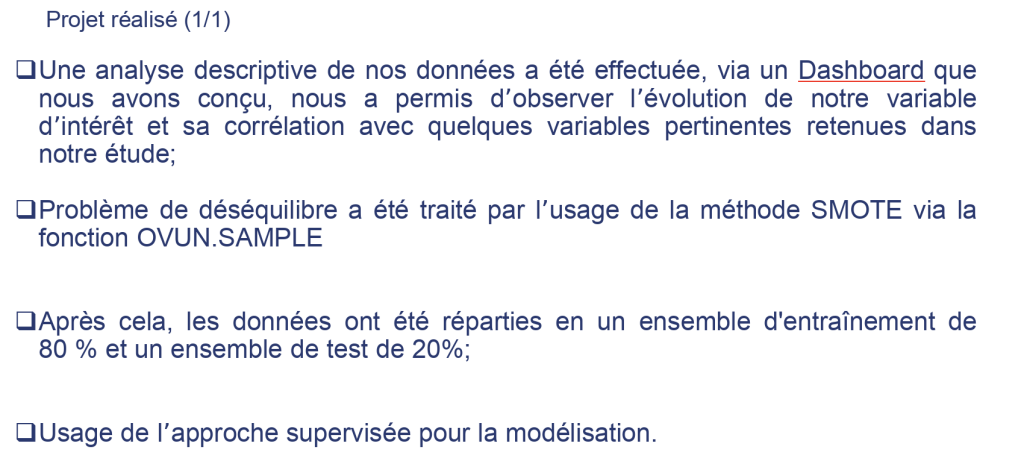
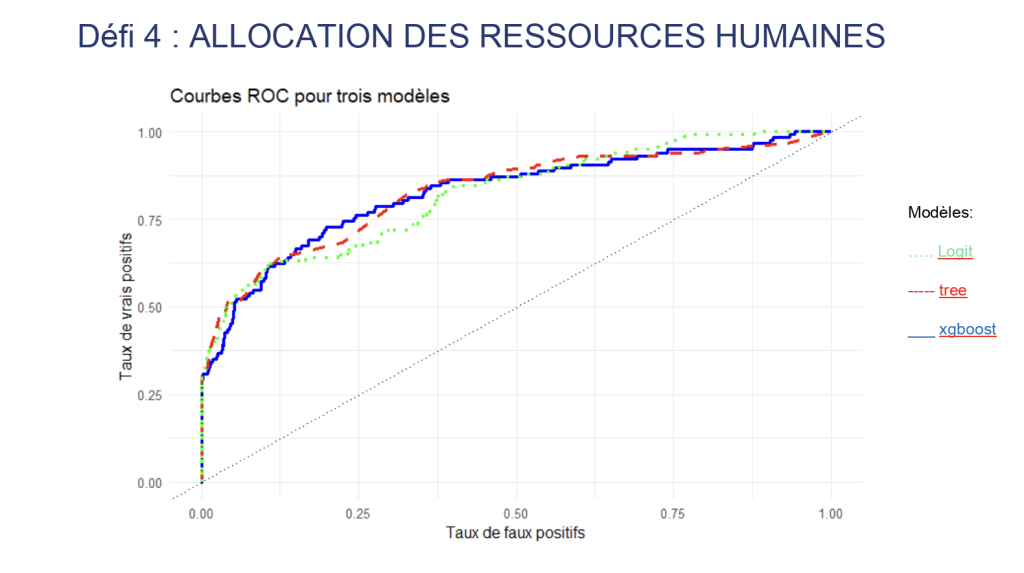
- Groupe 4 : pour évaluer la performance des vérificateurs en douanes effectuant des contrôles dans des bureaux d’enregistrement, le groupe a défini des indicateurs de performance liés au nombre de déclarations frauduleuses détectées, la plus value réalisée, et la célérité des contrôles. Le modèle construit autour de la prédiction des fraudes douanières (RandomForest, XGBOOST), permet de déterminer une méthode d’affectation des ressources humaines, “croisant” la performance des vérificateurs et le niveau de risque de fraude. L’une des perspectives dressées par le groupe pour la suite : prédire le délai de traitement d’une déclaration en fonction de ses caractéristiques et assigner automatiquement des déclarations aux vérificateurs.
Un passage de la théorie à la pratique réussi
Présents tout au long du hackathon, les coachs ont été les témoins et contributeurs du travail des groupes. Certains d’entre eux ont même enseigné au cours de la formation ENSEA. C’est le cas de Julien Ah-Pine, coach “transverse” du défi Datafid, qui est venu clôturer les 8 semaines de formation en présentant des méthodes de détection d’anomalies et des techniques d’anonymisation : “j’ai été particulièrement content de voir que plusieurs des groupes du hackahton ont directement appliqué ces techniques pour labelliser des données sur la détection de fraudes”.
Un passage de la théorie à la pratique dont Kimba, coach de groupe, décrit toute la valeur “même si ce n’est pas à maturité, le fait d’avoir appris les concepts, puis de travailler sur des données concrètes est un réel gain de temps. Après la formation et le défi, les participants vont rentrer au pays avec des modèles pour leur administration”.
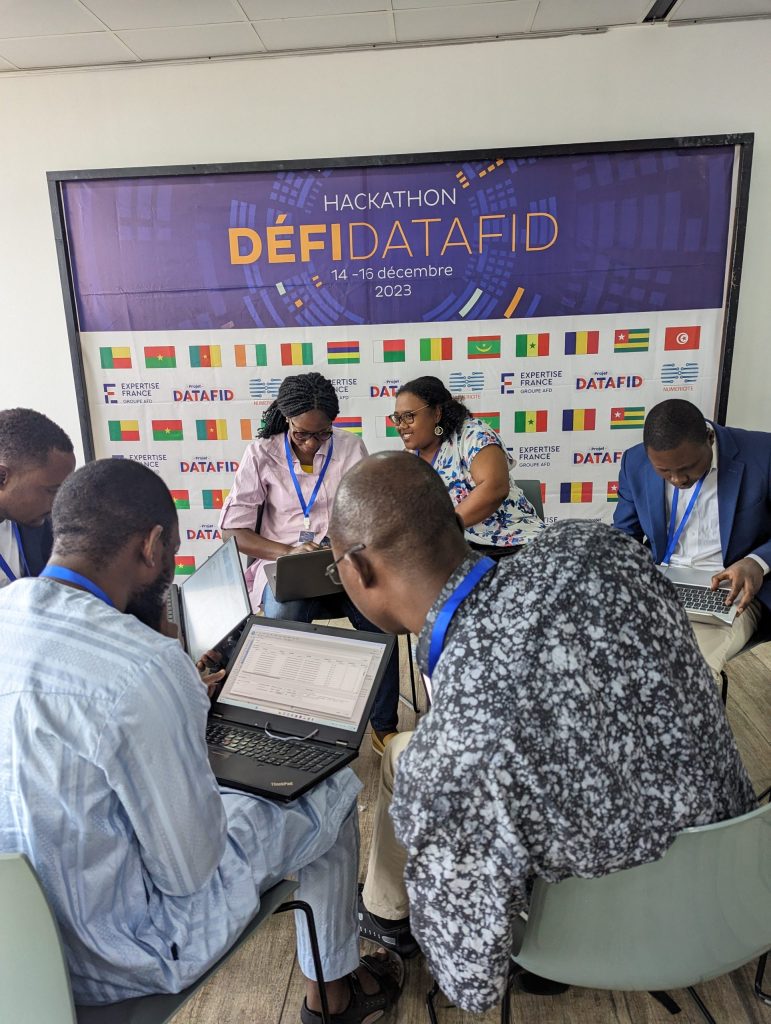
Le palmarès final : la mesure d’impact récompensée
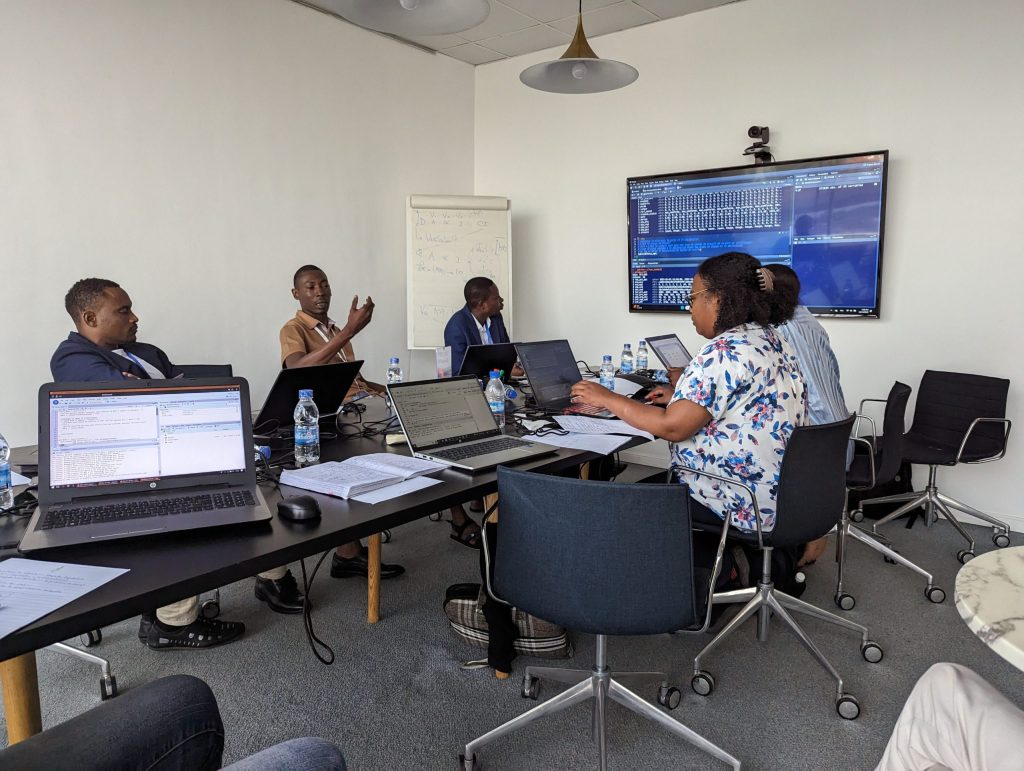
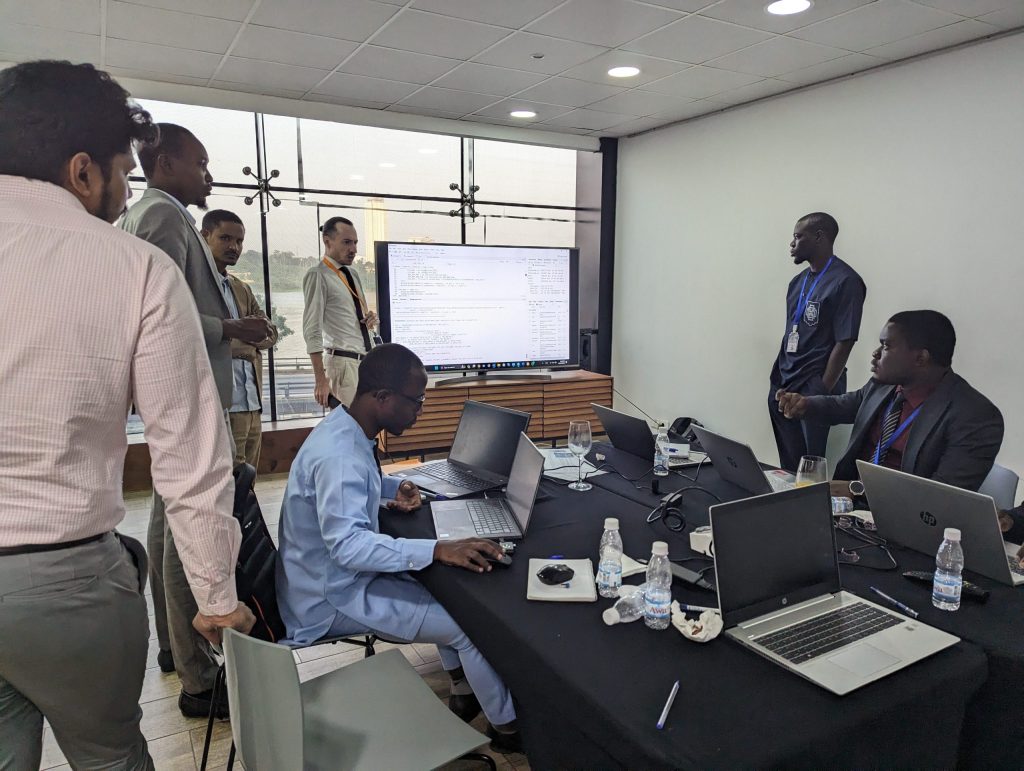
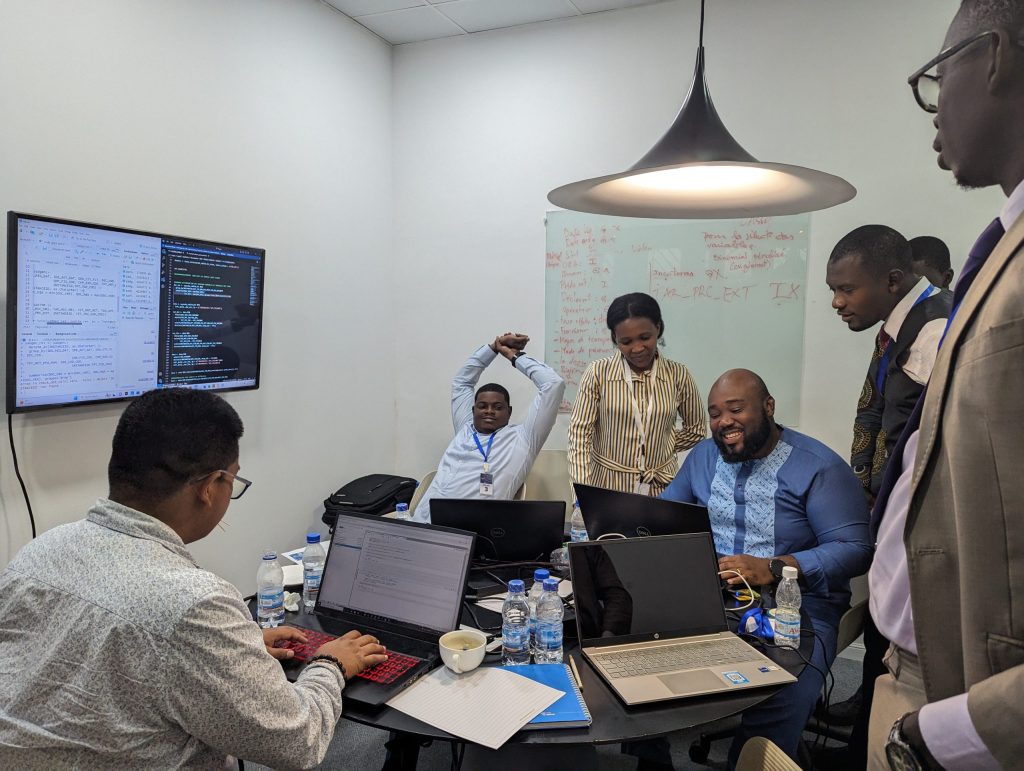
Au termes de 2 jours de travail, les groupes ont présenté tour à tour leurs résultats aux membres du jury, présents tout au long du défi. 5 critères d’évaluation : ****
- Créativité de la solution : approche innovante, capacité à mettre en pratique les résultats
- Pédagogie : capacité à expliquer la solution à divers profils, notamment des profils non-techniques
- Evaluation : évaluation du modèle, évaluation de l’impact métier
- Technique : à quel point la méthode et la technique appliquée est avancée ou adaptée
- Métier : inclusion du métier dans la construction de la solution et suivi des subtilités métiers
Le verdict ? Le choix a été extrêmement difficile, et c’est finalement au groupe 3 que la victoire est revenue. L’équipe a été récompensée pour sa capacité à mesurer l’impact des analyses : en obtenant un taux de performance de détection très élevé de déclarations sous-évaluées, le groupe a calculé un potentiel gain d’1 milliard de FCFA pour l’administration dans le futur. Les équipes ont par ailleurs mobilisé leurs compétences en Python pour présenter leurs résultats sur un tableau de bord, qui peut être utilisé par les directions pour piloter leurs actions au quotidien.
Un gagnant, mais de la valeur détectée pour chaque équipe, message partagé par l’ensemble des membres du jury et des coachs. Kimba, coach du groupe 4 considère que son équipe s’est démarquée par sa méthode d’évaluation de la performance des vérificateurs. Sadikh, coach du groupe 2, souligne la capacité du groupe a avoir mobilisé des données fiscales. Julien a été particulièrement attentif à l’approche méthodologique du groupe 1 pour associer les différents aspects du métier des douanes au paramétrage des données. Pour François Chastel, datascientist Numéricité, “les 4 défis ont été conçus pour être actionnables ensemble. Si on veut faire de la sélectivité en douanes, il est important d’approcher plusieurs aspects autour des données. Quand certains ont travaillé sur la préparation de données, d’autres ont davantage concentré leur effort sur la modélisation, ou encore le recoupement de données et enfin la construction d’un produit. Finalement, chaque groupe a accompli une brique d’un projet de data-science réussi. Par ailleurs, toutes les équipes sont reparties avec des résultats à appliquer pour leurs administrations. C’est donc un hackathon très complet et très actionnable à court terme.”
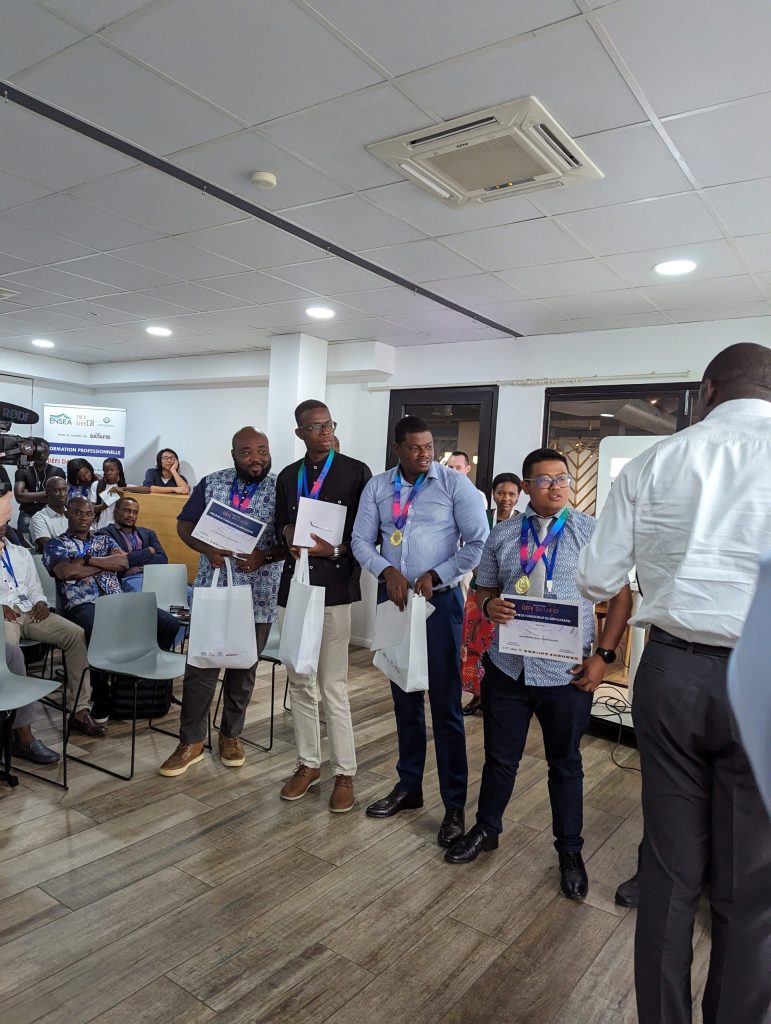
Les suites : quelles équipes pour l’édition 2024 ?
A l’issue des 3 jours de défi, l’ensemble des réalisations a été consolidé par les experts et partagés aux participants, afin qu’ils puissent réutiliser les méthodes, techniques et modèles prototypés.
Le défi Datafid 2023 a marqué les esprits à plusieurs égards. Son organisation intervient à l’issue de 2 ans d’implémentation du projet DATAFID, qui se clôture au premier trimestre 2024. Il aura ainsi permis d’élargir la communauté DATAFID auprès de nouveaux pays du continent. Clément Dupont, chef de projet, entrevoit de belles perspectives pour la suite : “il y a eu un véritable engouement autour de cet exercice, bien au-delà de ce qu’on imaginait. Certaines équipes ont travaillé jusqu’à 3, 4h du matin pour rendre la meilleure solution possible. Il est clair qu’après le défi DATAFID 2023, on va rapidement se projeter sur un défi 2024…”