Actualités & Datastories
Datastory #2 – Loi de Benford et douanes

02/10/2023
1. L’analyse de données, un outil de vérification et d’affinage des investigations douanières
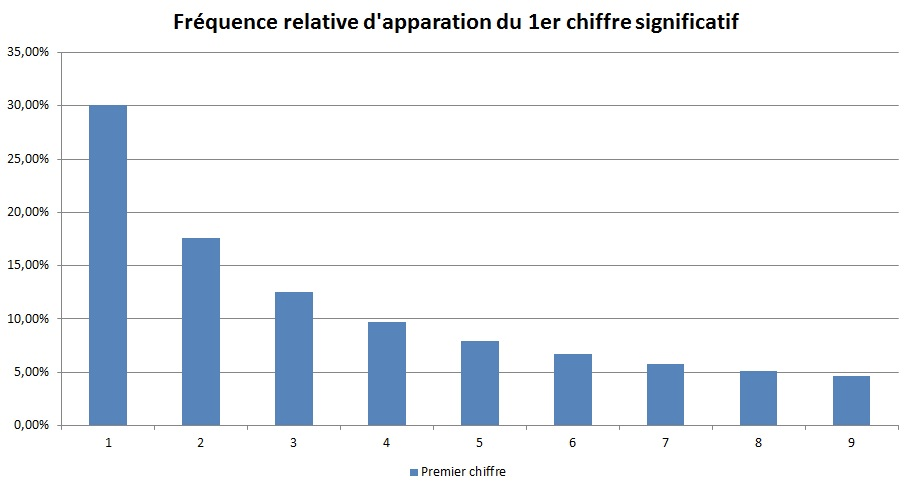
Afin de détecter des anomalies dans les enregistrements douaniers et les déclarations fiscales, les douanes utilisent notamment la méthode statistique appelée “loi de Benford” ou “loi des nombres anormaux”. Cette loi stipule que le premier premier chiffre d’un nombre issu de données statistiques réelles n’est pas équiprobable : le chiffre “1” est davantage présent que le chiffre “2”, lui-même davantage présent que le suivant, etc. Appliquée à des jeux de données douanières, cette règle permet aux agents de détecter des anomalies dans les déclarations et d’ainsi prioriser les investigations et les contrôles des marchandises.
Cette méthode est éprouvée dans de nombreuses disciplines. Dans notre cas, ces anomalies peuvent être de différentes origines : qualité des données à améliorer, choix métiers (nous y reviendrons), ou fraudes (sur les valeurs, les poids, l’origine, etc.).
vec l’appui des experts DATAFID, l’équipe de la direction des douanes a appliqué cette méthode statistique sur des données d’enregistrements douaniers et a mené des analyses plus poussées, augmentant le potentiel d’investigation.
💡 Précision sur le jeu de données utilisé : enregistrements douaniers (importations) anonymisés, pour l’année 2018, concernant 9 bureaux d’enregistrement, 1000 importateurs, 312 déclarants, et plus de 200 pays d’origine.
Comment cela fonctionne ?
- Les données sur les importations sont proposées en format csv. Ce format est très utile car il permet de présenter et d’analyser les données dans une variété d’applications, systèmes et langages de programmation. Ces données ont été préalablement anonymisées et nettoyées (pour éviter les doublons notamment).
- Pas à pas, la loi de Benford est appliquée :
- D’abord sur l’ensemble du jeu de données, pour observer la distribution générale et détecter des types d’anomalies à investiguer
- Ensuite nous choisissons deux variables (VALCAF et VALFOB, voir explications ci-dessous) sur lesquelles appliquer la loi de Benford, afin de détecter des anomalies plus spécifiques, en l’occurrence ici sur les importations liées à la consommation. Ce test a été réalisé en considérant les valeurs de fret et d’assurance déclarées par les importateurs
VALCIF : Valeur à l’importation et assurances, CIF signifie « Cost, Insurance and Freight » (en français VALCAF)
VALFOB : Valeur marchande, FOB signifie « free on board » (en française VALFAB, FAB pour « franco à bord »). Marchandise achetée ou vendue dans les frais du transport principal et autres taxes et frais d’assurance qu’il faut ensuite payer. Une marchandise à un prix « FOB » a toujours un prix inférieur au prix CIF.
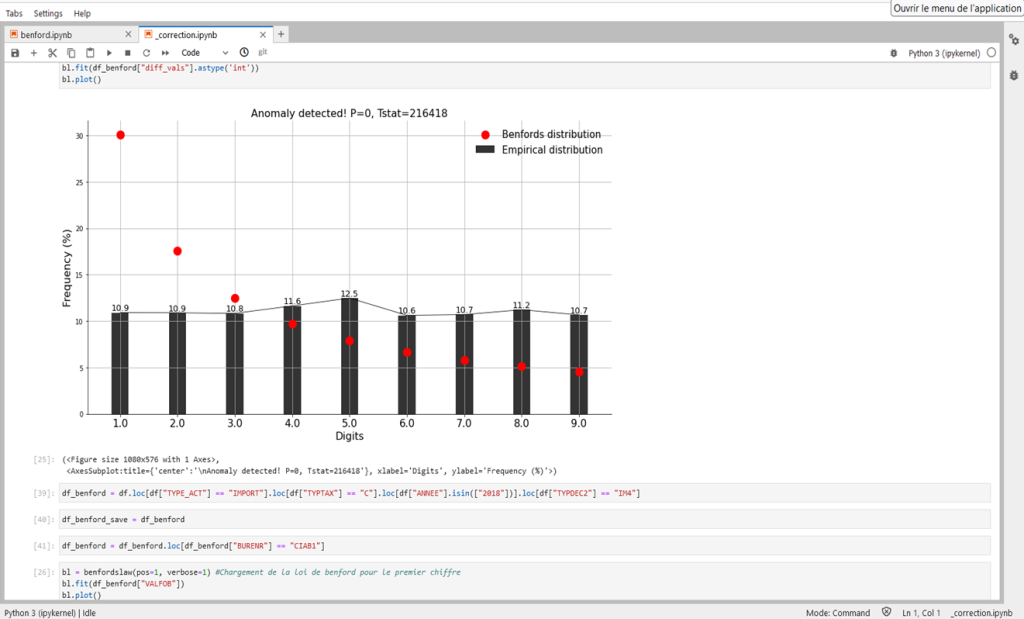
- En fonction des résultats, des focus plus spécifiques sont réalisés sur des produits ou des pays (loi de Benford appliquée sur les niveaux, 2, 4, et 6 et parfois 8 et 10 du code SH, ce afin d’avoir un échantillon significatif pour des analyses affinées)
💡 Comment lire la nomenclature SH et à quoi correspondent les niveaux ?
La nomenclature SH, pour “système harmonisé” (ou HS en anglais), est un système international de classification des marchandises utilisé en douanes afin de faciliter le commerce international. Il est utilisé pour déterminer les droits de douanes, les taxes à l’importation et disposer d’une vision précise sur la circulation des produits et marchandises.
Ce système est composé de codes numériques afin d’identifier les produits. Différentes profondeurs sont possibles, correspondant à un niveau de détail sur le produit :
Niveau de section (2 chiffres) : 21 possibilités, chacune représentant une catégorie générale de produits, comme les animaux vivants, les produits alimentaires, les machines, etc.
Niveau de chapitre (4 chiffres) : subdivision en chapitres, qui regroupent des produits similaires (pour la section “produits alimentaires”, on retrouve des chapitres sur les céréales, les viandes, les produits laitiers…)
Niveau de sous-chapitre (6 chiffres) : sous-chapitres pour une classification plus précise. Par exemple, le chapitre « Vêtements » peut être subdivisé en sous-chapitres pour les chemises, les pantalons, les vestes, etc.
Niveau de position (8 chiffres) : sub-subdivision en positions pour une identification encore plus précise des produits. Par exemple, la position « Chemises en coton pour femmes » pourrait être une classification à ce niveau
Niveau de sous-position (10 chiffres) : deux chiffres supplémentaires peuvent être ajoutés pour une classification encore plus détaillée. Ce niveau est plus rarement utilisé.
Ces étapes permettent de générer des visualisations et des analyses plus poussées, complémentaires avec la connaissance et l’expérience du terrain pour les douaniers.
- Afin de les valider, les résultats des tests Benford ont été comparés à la réalité, notamment la représentativité des enregistrements frauduleux, et ont permis d’identifier des évolutions à apporter dans les contrôles à réaliser (en fonction des produits, des bureaux d’enregistrements, etc.)
- Par ailleurs, les analyses ont aussi permis d’identifier des problèmes liés à la qualité des données (dans la collecte ou le formatage), et des opportunités de croisement avec des données externes (données macroéconomiques, informations sur les importateurs, données fiscales sur les opérateurs, etc.).
💡Application sur un cas concret : l’importation de véhicules
Dans les douanes du pays partenaire, l’importation des véhicules nous était indiquée par les douaniers comme étant un point de vigilance particulier.
Les données existantes ne permettaient pas aux agents d’effectuer une analyse approfondie sur les risques de comportements frauduleux : trop volumineuses et disparates, il était impossible de détecter des tendances, à moins d’inspecter les données enregistrement par enregistrement.
Avec l’utilisation de Benford, nous avons réduit le nombre de données à analyser en identifiant des groupes de données restreints dont les distributions des valeurs et des coûts ne respectaient pas la loi de Benford, nous permettant ainsi d’identifier des anomalies liées aux valeurs des véhicules en provenance d’un pays en particulier (Hongrie). Ces résultats ont permis aux équipes de procéder à des investigations complémentaires.
2. Pourquoi combiner l’utilisation de modèles statistiques avec des méthodes de data-science ?
Les avantages sont triples :
- Une augmentation de la vitesse d’analyse grâce à des formats de jeux de données standardisés et une puissance de calcul optimisée. A titre d’exemple, il faut seulement 2 minutes 30 pour analyser les données d’enregistrement des sept dernières années contre 2 heures pour un an de données auparavant
- L’opportunité d’améliorer la qualité des données et d’utiliser des langages universels et interopérables (notamment Python et R), contribuant ainsi à la pérennité de la méthode. Sur la qualité, dans le cas cité, certaines incohérences ont été détectées lors du profiling des données : 2% des produits avait un poids net inférieur ou égal à 0, ce qui est impossible dans la mesure où il s’agit de biens matériels.
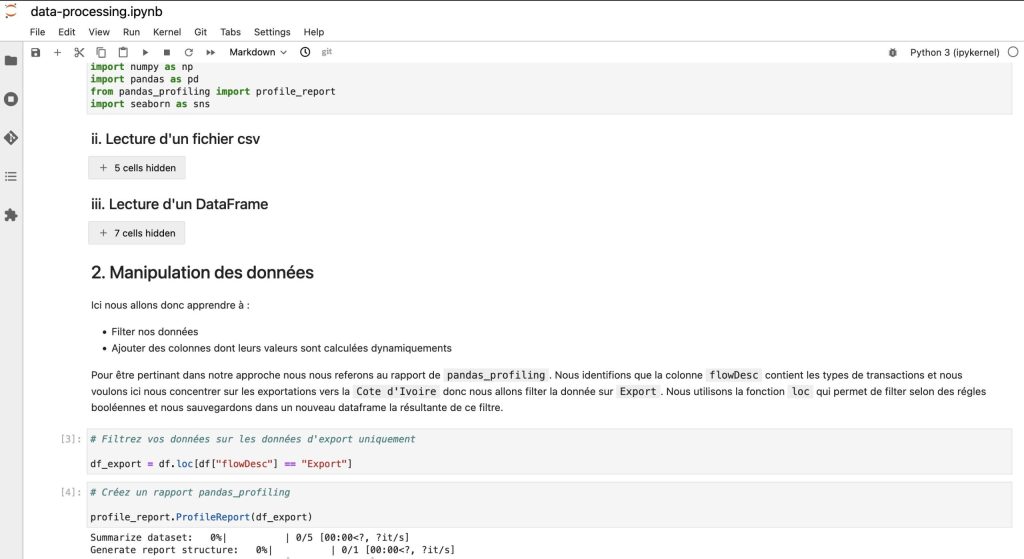
- Une traduction intelligente de règles métiers en code : un “notebook” est disponible pour tout statisticien qui souhaiterait fournir un rapport à un douanier sur le terrain, avec des “morceaux de codes” disponibles. Sur un produit, un pays d’origine ou de destination, un bureau d’enregistrement en particulier, il est possible de mener des analyses et de les visualiser simplement pour un douanier afin de mieux cartographier les anomalies (et a fortiori les comportements anormaux) et détecter des schémas de fraude.
3. Une première expérimentation prometteuse pour le pilotage de l’investigation douanière
Les travaux menés sur les données d’importation ont suscité un fort intérêt des services douaniers du pays partenaire, la détection d’anomalies sur des comportements passés permettant de mieux prévoir des contrôles futurs et d’outiller le pilotage de l’administration douanière en matière d’investigation et de contrôle.
Pour les équipes des douanes ayant travaillé sur le projet, les briques techniques mises à disposition lors de cette première expérimentation sont très utiles : “En réutilisant le script sur des données d’importation de fer, nous avons remarqué une baisse de prix plus prononcée que la baisse des prix à l’international. L’utilisation de Benford nous donne des arguments scientifiques plus poussés, nos recommandations de suivis et d’orientation des actions d’investigation douanières sont davantage étayées. C’était notre toute première expérience, et cela a créé un déclic dans l’ensemble du service : par exemple la direction en charge de l’évaluation pourra l’utiliser pour vérifier la déclaration des valeurs des marchandises. Et grâce au Datalab de DATAFID, nous allons pouvoir industrialiser la démarche et réaliser des analyses Benford plus régulièrement, sur de nombreux produits”.
La réalisation de ce cas d’usage avec les équipes des douanes a permis d’impulser une dynamique de montée en compétences en data-science. En remarquant le potentiel de techniques d’analyse, de mise en qualité et de visualisation de données dans leurs métiers, les équipes ont exprimé des besoins auprès des experts DATAFID pour réaliser d’autres cas d’usages et être formés à des langages et techniques data. A suivre dans de prochaines datastories !
En complément des différentes analyses menées sur les données, les experts DATAFID ont construit, avec les services statistiques, un tableau de bord projetant les données d’importation dans le temps et l’espace (via des datavisualisations) et les comparant aux infractions (y compris celles qui ont été ensuite caractérisées en fraude). L’outil utilisé : Apache Superset, une plateforme open source d’exploration et de visualisation de données, qui présente l’avantage d’être simple à installer et à utiliser.
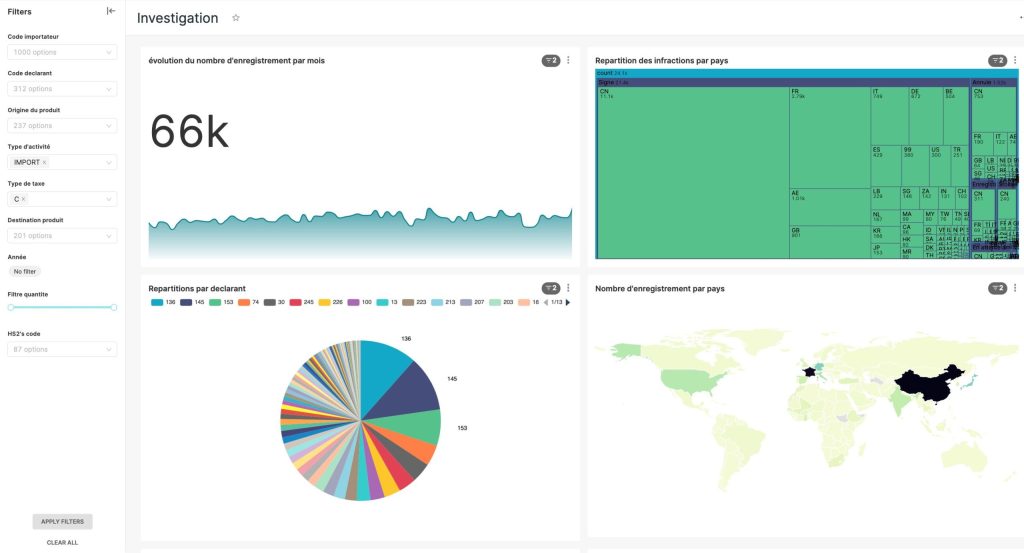
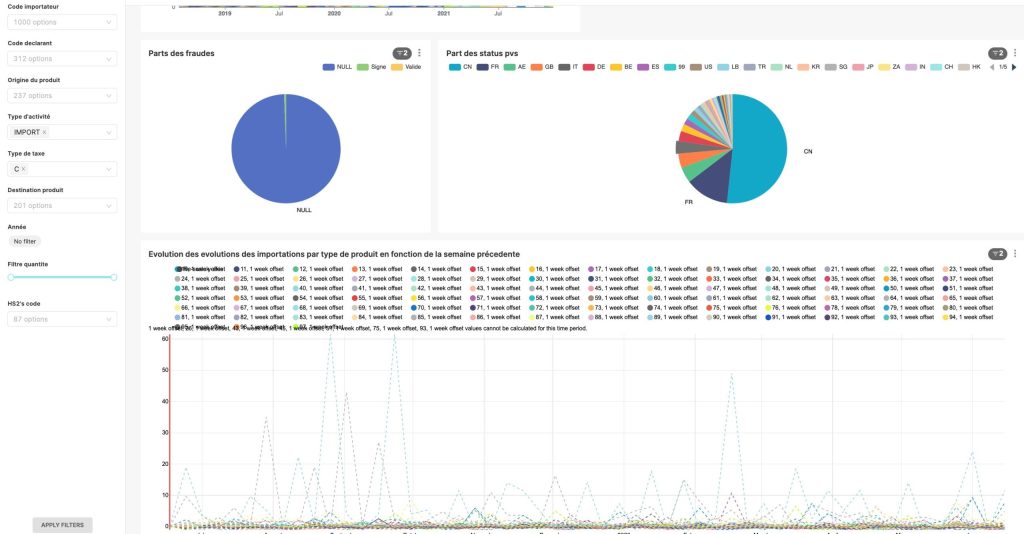
Ce type de visualisation permet ainsi d’analyser des tendances et se poser des questions afin de mieux évaluer et planifier les activités d’investigation en douane, par exemple :
- Pourquoi tel pays est-il sous-représenté ou sur-représenté en matière d’infractions ?
- Comment expliquer des variations périodiques des niveaux d’infraction constatées dans un bureau ?
- Constate-t-on des évolutions “suspectes” de valeurs sur un produit en particulier ?
- Les questionnements sont infinis !