Actualités & Datastories
Datastory #3 – Notation des contribuables

10/10/2023
1. Un système de notation des contribuables fondé sur des indicateurs à affiner
Depuis 2021, la DERAR dispose d’un système de notation de plus de 120 000 contribuables (entreprises et particuliers). Ce système évalue la discipline fiscale, c’est-à-dire la cohérence des acquittements des principaux contribuables ivoiriens. Il repose sur 26 indicateurs qui ont été définis par la DGI et sont utilisés par la DERAR pour la programmation des contrôles fiscaux à réaliser.
🧠 Le système de notation des contribuables comprend 26 indicateurs répartis en 5 axes :
– Discordances ou incohérences dans les données du contribuable
– Ratios et soldes comptables et fiscaux
– Comportements déclaratifs et paiements
– Antécédents ou historiques du contrôle fiscal
– Changements intervenus et évolutions du déclarant
La discordance de chiffres d’affaires est l’un des indicateurs qui intéresse aujourd’hui le plus la DERAR, du fait de son potentiel pour détecter la fraude. Il est calculé en réalisant une mesure de l’écart entre le chiffre d’affaires déclaré (et collecté dans le système d’information de la DGI) et les informations reconstruites depuis d’autres sources de données (notamment celles récupérées par un infocentre dédié géré par la DGI).
Au fil des séances, Judicaël Zaouli (sous-directeur à la DERAR, en charge de l’Analyse-Risque) a exprimé le souhait d’intégrer de nouvelles méthodes et sources de données pour moderniser et rendre plus efficaces les analyses réalisées par ses collaborateurs.
Pour répondre à ce souhait, l’approche a consisté à faire monter en compétences l’équipe de la DERAR sur de nouveaux outils et techniques de manipulation, traitement et visualisation de données (Superset, programmation Python) tout en abordant une problématique appliquée aux missions de la direction : les modèles d’analyse-risque et d’orientation des contrôles.
Pour démarrer, les experts DATAFID ont étudié avec plus d’attention le système de notation des contribuables (SNC-CI). Un tableau de bord, visualisant les 26 indicateurs du système de notation des contribuables a été créé à l’aide de l’outil Superset :
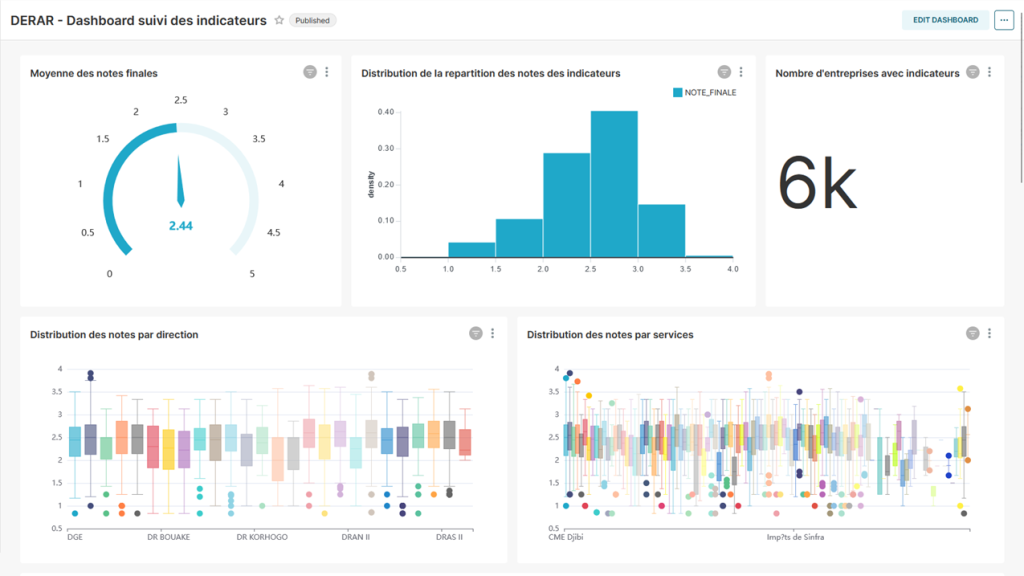
Cette visualisation a permis de réaliser un premier constat : de nombreux contribuables ne sont pas évalués sur l’ensemble des indicateurs, pour deux raisons :
- d’abord, les calculs sont parfois trop fastidieux ;
- ensuite, tous les indicateurs ne sont pas nécessairement pertinents selon les catégories de contribuables ou de secteurs d’activité, si bien que la plupart des indicateurs ne sont pas renseignés pour la totalité des contribuables.
2. Expérimenter de nouvelles méthodes pour créer de nouveaux indicateurs
Afin d’identifier des voies d’amélioration du système de notation du contribuables, et a fortiori, construire de nouveaux indicateurs, les équipes ont décidé d’analyser une partie des données en appliquant la loi de Benford.
💡La “loi de Benford” ou “loi des nombres anormaux” est une méthode statistique utilisée pour ensuite prioriser des investigations ou des contrôles. En vulgarisant, si un jeu de données ne respecte pas une distribution statistique standard appliquée sur les premiers chiffres, il est fort possible que des anomalies existent. Les experts DATAFID l’ont déjà mobilisée dans un contexte douanier. Voir la Datastory #2
Les données sélectionnées pour cette expérimentation Benford sont les factures émises par les principaux contribuables ivoiriens pour l’année 2022. Le choix de la DERAR s’est tourné vers ces données pour les raisons suivantes :
- il s’agit de données que l’on peut plus simplement regrouper selon des critères communs
- le volume de données est satisfaisant (375 000 lignes)
En analysant ces données, qui contiennent des informations telles que la nature de la marchandise, le montant, l’intitulé, l’année fiscale, la date de la facture et les identifiants anonymisés des clients et fournisseurs, l’équipe a commencé à réfléchir à la création d’un nouvel indicateur qui traduirait les résultats de cette analyse : la classification des contribuables en fonction de l’adéquation entre la distribution des montants des factures observées et la distribution attendue théoriquement par Benford.
Il s’agit de vérifier la distribution des données réelles avec celle attendue de la loi de Benford. Un écart statistique trop grand pourrait signaler une anomalie, comme une sous-facturation, et indiquer un risque de fraude, donc une perte fiscale pour l’administration.
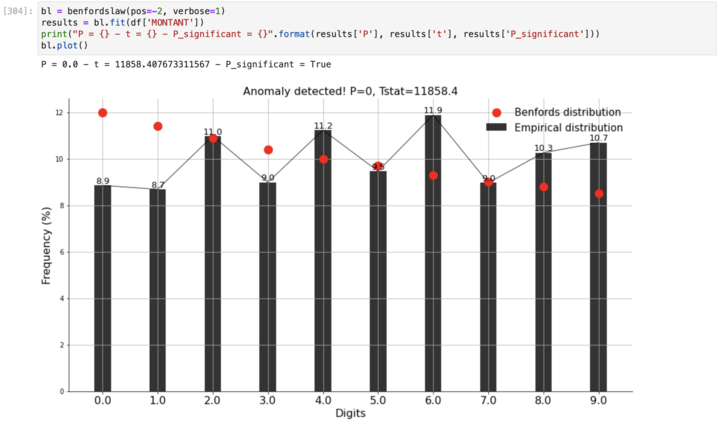
Les points en rouge indiquent la distribution de l’avant dernier chiffre tel qu’attendu par Benford (combien de fois on est censé avoir un 0, un 1, …, un 8 et un 9 en avant dernière position sur le montant des factures). Les barres représentent ce qu’on observe réellement en analysant les données. On obtient un ensemble d’information lorsqu’on lance l’analyse : – un écart statistique (entre ce qu’on attend et ce qu’on observe) que l’on note – une p-value (coefficient de corrélation entre observé et théorique – si proche de 0 alors aucune corrélation donc anomalie, si proche de 1, alors comportement proche à la distribution théorique) – un p-significant : valeur booléenne qui se base sur la p-value. En-deça d’un seuil (0.05 → < 5% de corrélation) alors on dit que l’écart est significatif et donc on considère une anomalie.
3. Un prototype fonctionnel permettant un meilleur contrôle des factures
Une fois la première application de la loi de Benford réalisée sur l’ensemble des données de facturation, les factures ont été regroupées selon des critères spécifiques afin d’étudier de manière plus fine leur distribution, comparée avec la distribution attendue par la loi de Benford.
Les étapes pour construire ce prototype :
- Pré-processing, c’est la manipulation et la transformation de données brutes pour les rendre adaptables aux modèles d’analyses utilisés (suppression des valeurs nulles ou aberrantes, normalisation des variables, etc. sur un total 375K lignes avec 2257 fournisseurs.)
- Regroupement des factures selon un critère spécifique. Ce sont nos variables catégorielles : nature de la marchandise, fournisseur, activité, libellé, exercice.
- Observation de la distribution statistique pour chaque groupe de factures et comparaison avec la répartition attendue selon Benford. On obtient alors un écart statistique (à quel point l’observation diffère de la distribution attendue) et une *p-value (*concordance entre les distributions empiriques et théoriques.)
- Pondération des résultats obtenus, et classement des contribuables selon leur p-value : lorsqu’un écart trop grand est observé (p-value < 0.05), le groupe est catégorisé à risque, une analyse devra être opérée pour vérifier s’il s’agit d’un comportement frauduleux.
Plus aller plus loin techniquement :
1ère étape : regroupement des factures et analyse de leur distribution au sein du groupe.
En entrée :
– variable catégorielle → Sur quel critère je regroupe mes données
– variable quantitative → Sur quelle valeur j’effectue mon analyse (montant des factures)
– seuil de pertinence → Nombre de factures minimum pour réaliser l’analyse avec Benford (ici au moins 50)
– dataframe → jeu de donnée utilisé pour l’étude
En sortie :
– une matrice avec les p-values obtenues pour chaque élément distinct de la variable catégorielle choisie (pour l’ensemble des fournisseurs par exemple)
2ème étape : classification et mise en graphiques des résultats obtenus
En sortie :
– répartition sous forme de graphiques des groupes selon les résultats observés dans la matrice : distribution conforme à la loi de Benford, distribution anormale, ou pas assez de données d’étude
Un exemple, sur les fournisseurs :
– 25 % n’ont pas assez de données (n’ont pas émis assez de factures)
– 40% d’entre-eux présentent une distribution anormale
– les 35% restants semblent conformes
3ème étape: appréciation des résultats obtenus et classement des profils à risque
En sortie :
– pondération des p-values selon divers critères (nature des marchandises, secteurs d’activité, etc.), classement des groupes selon les résultats obtenus, et attribution d’une note sur un barème à 5 points.
Cependant, l’utilisation de Benford peut faire face à certaines limites. D’abord, le modèle doit mobiliser un volume de données conséquent. Ensuite, les résultats ne peuvent être pris en tant que tels et doivent l’objet d’une interprétation humaine, par des individus familiers des réalités du terrain. D’où l’importance de travailler en étroite coopération avec les équipes de la DERAR, qui sont seules en mesure d’apprécier les résultats obtenus et d’ajuster le modèle en fonction des enseignements tirés d’autres indicateurs déjà en place. En d’autres termes, la loi de Benford ne propose que des indices qui doivent être affinés par un jugement humain.
Pour Judicael Zaouli, sous-directeur de l’analyse du risque et de la veille stratégique à la DERAR, “Les compétences acquises grâce au projet DATAFID, notamment la maîtrise du langage Python et de l’outil Superset, nous sont utiles au quotidien car nous manipulons constamment des données. Elles nous permettent de travailler avec une plus grande célérité. Pour ce qui est de l’application de la loi de Benford, celle-ci complète notre approche de la sélectivité des contrôles fiscaux. Nous comptons la combiner aux méthodes métier existantes, d’autant qu’en ce moment nous préparons le plan de contrôle annuel. Le projet DATAFID a installé une dynamique plus poussée, au travers de l’accompagnement et des rencontre, ce qui nous encourage à aller plus loin.”
4. Un prochain modèle d’analyse-risque mêlant Benford et machine learning ?
Après avoir appliqué la loi de Benford à l’ensemble des contribuables pour les classer, l’objectif est d’effectuer une analyse plus approfondie par secteur et par catégorie : secteur d’activité du contribuable, nature et volume des marchandises échangées, etc. Pour cela, le projet réfléchit à la construction d’un nouveau modèle qui intègre les approches statistiques permises par Benford à des fonctions plus poussées de machine learning. Il s’agirait de fusionner des techniques d’analyse sophistiquées pour affiner les paramètres du système de notation et créer un outil d’évaluation des risques hautement efficace, en mesure de mieux orienter les contrôles fiscaux et potentiellement de lutter plus efficacement contre la fraude.
Il serait probablement intéressant de s’inspirer de la méthode BACUDA, qui s’applique dans un contexte douanier, en vue d’élaborer, cette fois dans le domaine fiscal, une grille de risque selon différents paramètres.
📢 Le projet BACUDA (BAnd of CUstoms Data Analysts), initié par l’Organisation mondiale des douanes (OMD), est une avancée majeure dans le domaine de l’analyse des données douanières. Il représente une transition vers une approche plus analytique des modèles de sélectivité des contrôles douaniers. Son objectif ? Entrainer un modèle d’apprentissage automatisé pour mieux prédire les importations frauduleuses.
« BACUDA » signifie « changement » en coréen.
*https://mag.wcoomd.org/fr/magazine/omd-actualites-91-fevrier-2020/bacuda/*