DATAFID, c’est aussi une dynamique de montée en compétences ! Pour guider les statisticiens des douanes et des impôts dans le passage à l’action – mobiliser la donnée dans leur quotidien – les experts du projet conçoivent et animent des sessions de travaux pratiques auprès des équipes. Les objectifs : donner toutes les capacités aux administrations accompagnées de pouvoir réaliser des travaux en autonomie et faire en sorte que les équipes maîtrisent, étape par étape, des opérations basiques ou plus poussées en science des données.
Comment ces TP ont-ils été conçus ? Quelles sont leurs modalités d’animation ? Quels résultats peut-on observer ? Quels impacts sur la réalisation de cas d’usage métier ? Quelles bonnes pratiques en retirer ?
Plongée dans l’univers des experts DATAFID Vincent Motte, coordinateur de la conception et de l’animation des TP, Mehdi Rafenne, animateur de modules de formation et TP, et François Chastel, concepteur des TP de datascience avancée.
Cet article revient sur les actions réalisées de janvier à septembre 2023
en Côte d’Ivoire auprès des équipes de la DARRV (Direction de l’Analyse du Risque, du Renseignement et de la Valeur des douanes) de la Direction Générale des Douanes, et de la DERAR (Direction des Enquêtes, du Renseignement et de l’Analyse-Risque) à la Direction Générale des Impôts
au Togo auprès des équipes de l’Office Togolais des Recettes (OTR)
en Mauritanie auprès de la Direction Générale des Impôts.
1. Les TP DATAFID : une passerelle entre la formation et la réalisation d’un cas d’usage data
Au démarrage du projet DATAFID en 2022, les experts ont conçu quelques démonstrations basiques de manipulation des données afin de sensibiliser les équipes sur des opérations élémentaires : importer un fichier (CSV, XLS) en Python, structurer des données, produire un tableau de bord basique, utiliser des librairies spécifiques, etc.
Assez rapidement, l’idée de transformer ces “démo” en un parcours de formation est apparue : non seulement pour permettre une montée en compétences par le faire, mais aussi car les équipes exprimaient des freins techniques et méthodologiques dans le test et la réalisation de cas d’usage ou dans l’utilisation du Datalab, l’espace de travail “data” de DATAFID. Quelques exemples de difficultés rencontrées :
à la DARRV (administration douanière ivoirienne), des agents ne parvenaient pas à importer des données dans un outil de visualisation de données ;
à la DERAR (administration fiscale ivoirienne), les données devaient être transformées pour permettre des analyses plus poussées.
Pour répondre aux besoins, les experts ont construit des parcours adaptés, les ont rendu disponibles sur le Datalab de DATAFID, testés et enrichis au fil du temps, grâce aux retours des équipes.
Comment se déroule le parcours ?
Dans un premier temps, les équipes suivent des formations, conçues en modules d’initiation, afin de maîtriser les fondamentaux. Toutes les semaines, des sessions de 2h sont animées avec les cadres des administrations des trois pays, et les équipes progressent dans leurs parcours. Il est possible de suivre ces modules en autonomie et complètement en ligne.
La plupart des modules d’initiation sont des réutilisations de la plateforme SSPCloud (voir encadré ci-dessous).
💡 Le projet DATAFID a bénéficié des communs de la plateforme SSPCloud
SSPCloud est un espace communautaire pour la statistique publique animé par divers agents publics français. De nombreux communs sont disponibles sur cette plateforme, notamment des modules d’initiation aux langages R et Python. Les experts DATAFID ont pu réutiliser ces modules théoriques dans le cadre du parcours de formation des agents fiscaux et douaniers des pays partenaires. Ils ont également pu mettre en oeuvre le datalab Onyxia, plateforme de datascience opensource mise à disposition par SSPCloud. Les agents ont pu se former à l’utilisation de ce datalab sur la base des contenus proposés par SSPCloud ainsi qu’à des cas d’usages métiers formulés par les experts DATAFID.
Merci aux équipes du SSPCloud, plus particulièrement aux agents de l’Institut National de la Statistique et des Etudes Economiques (INSEE) et du ministère de la Transition écologique et de la Cohésion des territoires, d’avoir créé des communs qui facilitent l’apprentissage de la datascience par les agents.
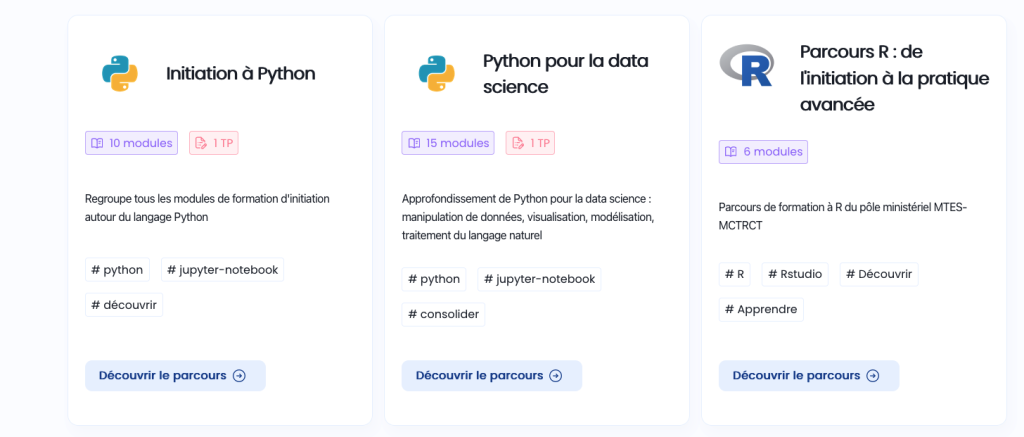
Le « parcours découverte » mis à disposition des équipesAperçu du module de formation “Pratique de pandas : un exemple complet”
Dans un second temps, une fois les modules de formation terminés, les équipes peuvent suivre les TP, créés par les experts DATAFID. Les trois premiers TP conçus au premier semestre 2023 sont les suivants :
TP Data Processing – C’est le point d’entrée obligatoire ! En deux à trois séances d’1h30-2h, les bénéficiaires maîtrisent davantage les environnements Jupyter Notebook proposés par le Datalab et savent mobiliser les librairies pandas et numpy. Ce TP permet également de mesurer le niveau des bénéficiaires pour leur proposer des séquences de travail sur mesure.
TP Superset – On crée des data visualisations ! En trois séances d’1h30-2h, les bénéficiaires découvrent l’environnement Apache Superset, travaillent avec des données, et produisent des tableaux de bord.
TP Benford – En trois séances d’1h30-2h, l’objectif est d’apprendre à préparer les données pour appliquer un modèle Benford (détection d’anomalies) via plusieurs opérations : rendre les données exploitables en supprimant les données inutiles ou aberrantes, filtrer les données pertinentes, s’assurer que l’on dispose d’une quantité suffisante de données, réaliser des groupements de données, etc. Pour en savoir plus sur la loi de Benford, consultez notre dernière datastory à ce sujet.
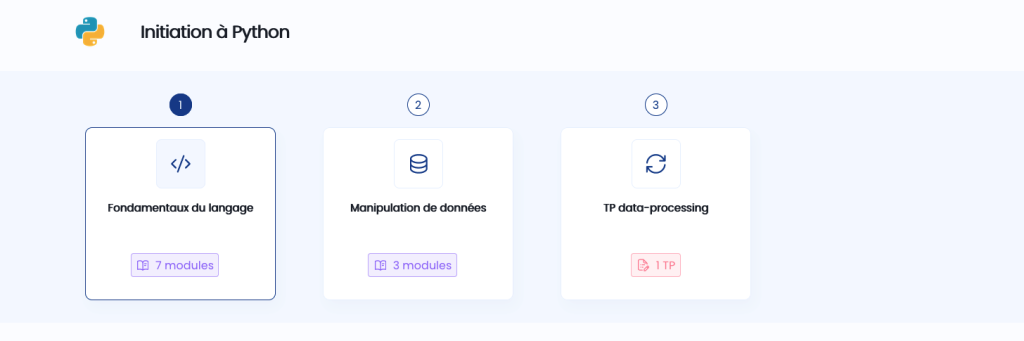
Avant de suivre le TP data-processing, il faut suivre les modules fondamentaux Python et manipulation de données
2. L’animation et la réalisation des TP DATAFID : au plus près du quotidien des agents
On ne les appelle pas TP pour rien ! La méthode d’animation, le contenu et le format des TP sont conçus pour s’adapter au quotidien des agents.
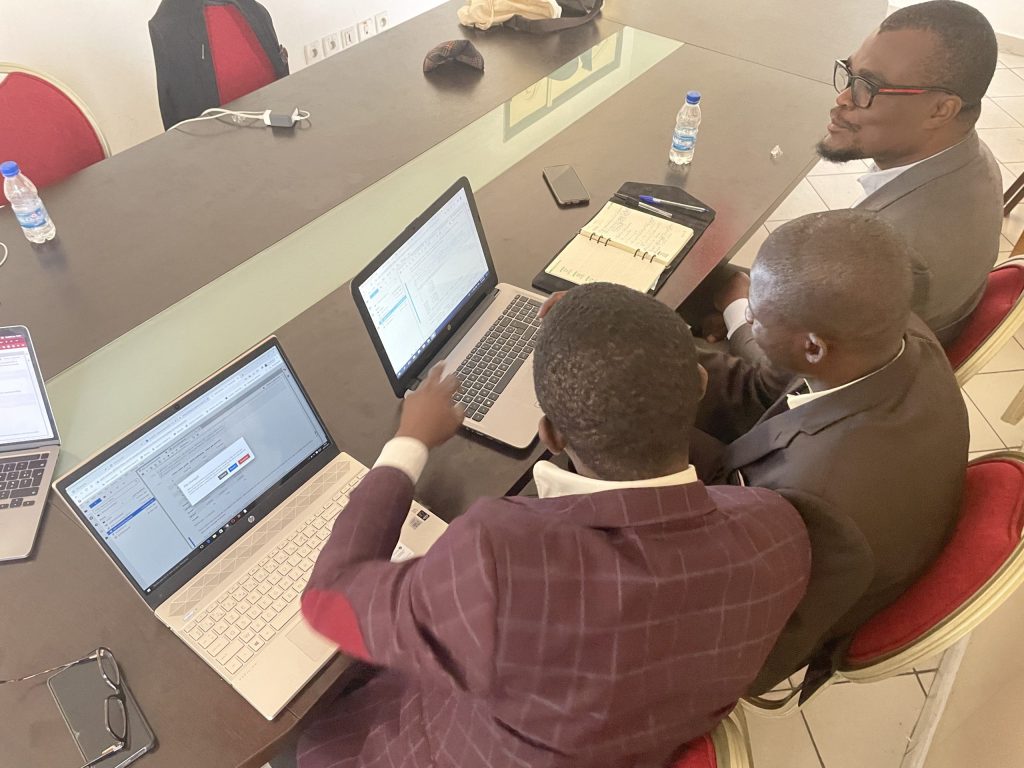
Les TP sont dispensés de manière régulière : en Côte d’Ivoire, les équipes de la DARRV (douanes) se sont réunies en présentiel une fois par semaine, et celles de la DERAR (impôts) tous les 15 jours. La présence physique facilite l’entraide et la résolution rapide de problèmes, les animateurs étant au plus près des apprenants. Des sessions hebdomadaires en distanciel ont par ailleurs été dispensées auprès du Togo et de la Mauritanie.
💡 Quelques chiffres clefs :
De janvier à septembre 2023, auprès de la DARRV et de la DERAR en Côte d’Ivoire :
une cinquantaine de sessions de TP ont été réalisées
le TP dataprocessing a été réalisé par 50 personnes
le TP Superset a été réalisé par 30 personnes
le TP Benford a été réalisé avec la DAARV
2 administrations ont été jusqu’à créer des tableaux de bord (cf. plus loin)
150 modules de formation ont été lancés et suivis par les agents
D’août à septembre 2023 :
En Mauritanie : le TP Data processing a été animé en distantiel auprès des équipes de la DGI (10 personnes)
Au Togo : les TP Data Processing et Benford ont été animés en présentiel auprès des agents de l’OTR (impôts et douanes, 20 personnes)
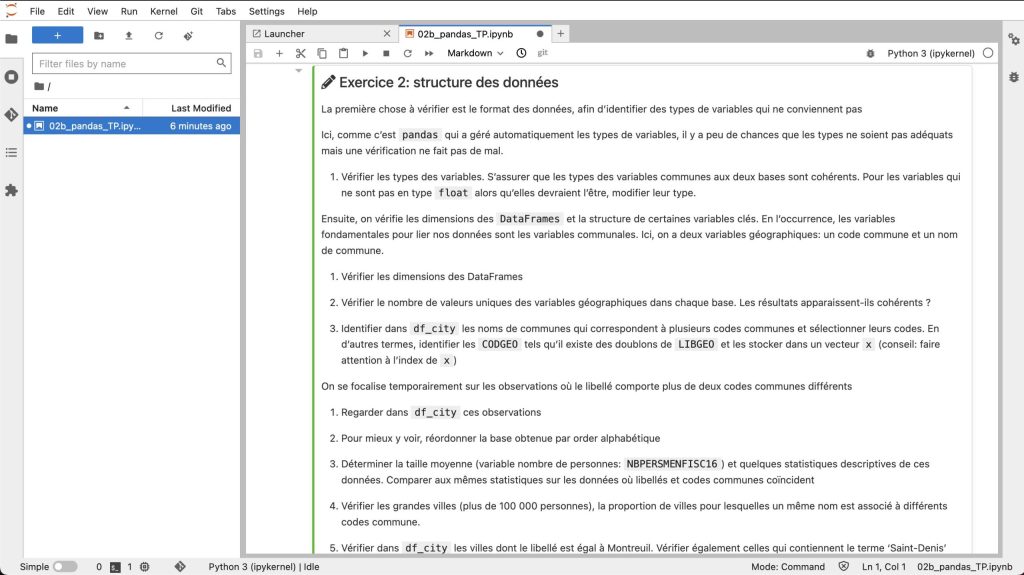
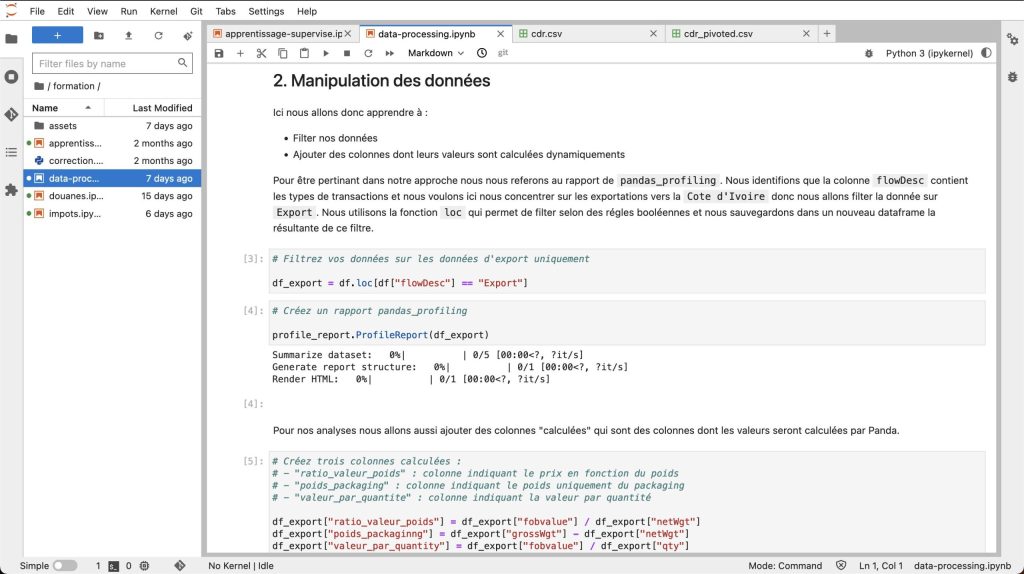
Les TP sont conçus comme des “pas à pas” sur des Jupyter Notebook, un environnement de développement qui mêle code et texte formaté. A chaque étape du TP, les agents doivent compléter des champs et les exécuter afin de pouvoir avancer dans le programme. Ils apprennent ainsi progressivement et sont accompagnés au cours de la séance par les experts DATAFID.
A chaque étape du TP, les agents doivent compléter des champs et les exécuter afin de pouvoir avancer dans le programme. Ils apprennent ainsi progressivement et sont accompagnés au cours de la séance par les experts DATAFID.
Les TP sont configurés de manière à faciliter l’utilisation de données en toute sécurité : l’accès aux TP est protégé (chaque utilisateur a un compte et un mot de passe, et le lancement d’une instance de Jupyter Notebook nécessite un token – jeton d’accès – spécifique connu du seul utilisateur), et les données utilisées sont anonymisées ou agrégées (datastory à venir).
Séance de TP avec la DERAR, Côte d’IvoireCapture d’écran du TP dataprocessing (Jupyter Notebook)
💡 Le programme type d’une session de TP
Retour sur les activités réalisées en asynchrone (modules de formations, exploration de nouvelles données partagées)
Présentation des objectifs de la séance
Séquence théorique (par exemple : présentation du modèle mathématique associé au TP, fondamentaux du langage utilisé lors du TP, notions clefs, etc.)
Mise en pratique : lancement et réalisation (individuellement ou collectivement)
Mise en commun : apprentissages, problèmes rencontrés, projections sur des données et cas concrets d’utilisation
Questions & Réponses
Ouverture : consignes et exercices en préparation de la session suivante
3. Le résultat : par le faire, mobilisation de nouvelles compétences et identification de nouveaux cas d’usages
Les sessions de TP sont de véritables moments “d’apprentissage appliqué” pour les participants, qui acquièrent petit à petit de nouvelles compétences mobilisables sur le long terme. Par exemple : paramétrer un fichier csv dans un dataframe en fonction de sa nomenclature, classer et structurer des variables, créer de nouveaux dataframes à partir de données agrégées, extraire des informations statistiques sur un jeu de données (distribution de valeurs, corrélations, incohérences), importer des données dans/depuis PostgreSQL, réaliser des requêtes SQL, construire des tableaux de bord interactifs, etc.
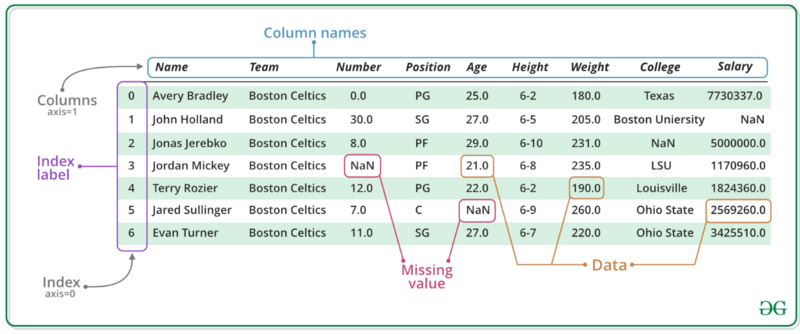
💡 Qu’est-ce qu’un dataframe ? Un dataframe est une structure de données proposée par la librairie Pandas (inspirée du langage R). On peut le voir comme l’équivalent d’une table dans une base de données relationnelle : le dataframe se compose de colonnes (ou variables, de type potentiellement hétérogènes) et de lignes (ou observations), qui peuvent être indexées ou labellisées.
La manière dont les TP sont structurés présente plusieurs autres avantages. L’immersion dans des outils et frameworks de datascience permettent aux administrations de réappliquer leurs connaissances dans des situations concrètes (cas d’usages) grâce à la construction du Datalab de DATAFID (article à venir). Il est possible de rejouer les TP en autonomie, sur d’autres données. En se formant à une technique de datascience, les administrations identifient des nouveaux besoins en opérations de base, ce qu’on appelle ici les “datatouilles” : jointure de base de données, transformation de variables catégorielles en variables quantitatives, etc.
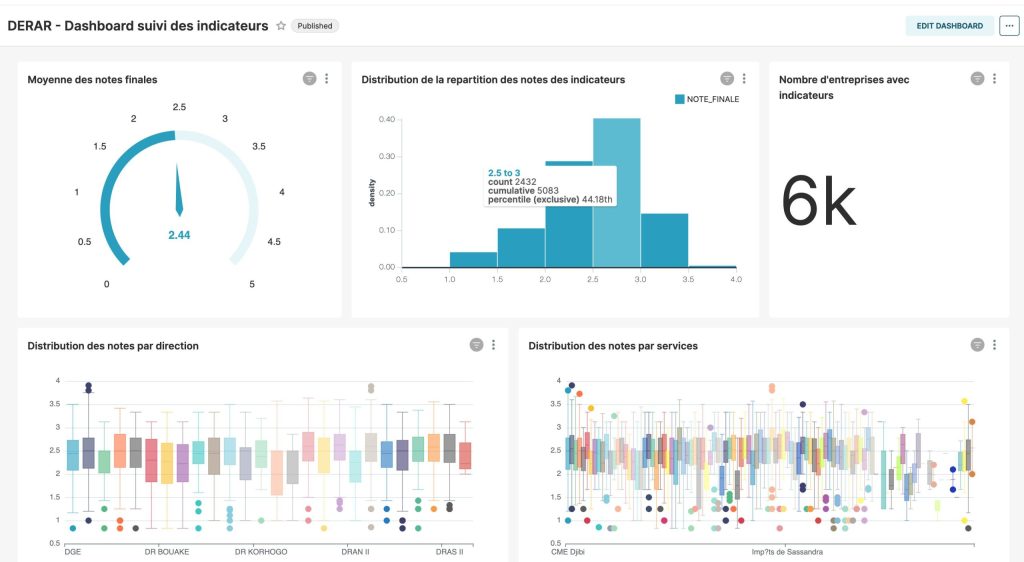
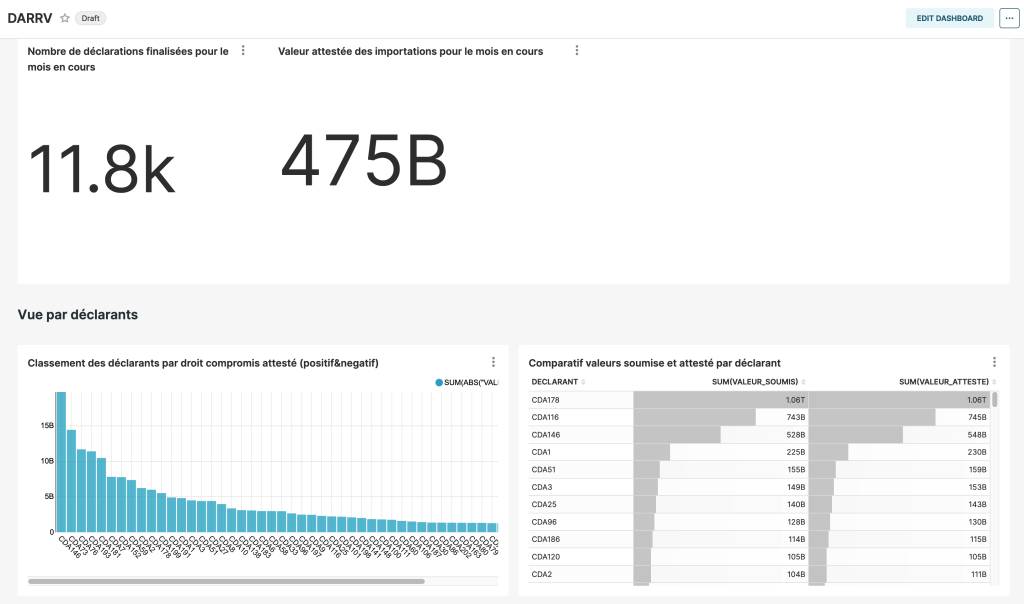
Aperçu d’un tableau de bord réalisé par les agents de la DERAR lors d’un TPAperçu d’un tableau de bord réalisé par les agents de la DARRV lors d’un TP
C’est une boucle vertueuse qui se crée.
Une fois les TP réalisés, les agents obtiennent une meilleure compréhension de leurs données et de leurs potentiel, et parviennent plus facilement à identifier les domaines où l’appui de DATAFID s’avère utile. Ainsi des idées d’usage plus poussées émergent. Avec l’administration fiscale en Côte d’Ivoire, la construction de tableaux de bord permise par Superset a suscité un intérêt pour un travail sur les profils de notation des contribuables, et pour la mise à disposition d’outils d’aide à la décision. Au Togo, à l’issue du TP Data Processing, les équipes ont souhaité créer un modèle d’apprentissage supervisé pour améliorer la sélectivité des contrôles en douanes. Par ailleurs, des bonnes pratiques et un esprit de communauté et d’entraide émergent. Des échanges informels ont lieu sur un groupe WhatsApp, qui permet aux animateurs de répondre aux demandes d’aide et de construire le programme des sessions de TP à venir. Enfin l’expérience se propage : d’autres administrations s’intéressent aux TP et participent aux séances suivantes !
4. La suite : vers des TP plus poussés, orientés vers la production de cas d’usages
Fort de ces apprentissages, l’équipe d’experts se mobilise pour faire évoluer et enrichir ce parcours. Plusieurs axes de travail ont été explorés et sont en cours de conception :
La construction de nouveaux TP plus poussés en data science ou l’évolution de certains TP :
Webscrapping : en 2h, créer des jeux de données peu ou pas standardisées en récupérant le contenu de pages web afin de mener des analyses. Ce TP a été animé auprès de l’OTR (Togo) et la Côte d’Ivoire
Anonymisation : intégration d’un exercice dédié dans le TP Dataprocessing
Des réflexions sont en cours pour d’autres TP : formation complète en SQL, techniques d’apprentissage supervisé
Des formations ou ateliers ad hoc, adaptés au niveau de maturité des équipes ou répondant à des besoins pour réaliser des cas d’usage : identification de données, techniques de datavisualisation, construction de modèles d’apprentissage supervisés, approches générales du machine learning, etc.
Une réflexion ouverte sur la mutualisation des besoins et des techniques de résolution de problèmes pour constituer une base de connaissance dynamique (FAQ ou équivalent d’un “Stack Overflow”)
💡 En conclusion : les 5 bonnes pratiques à retenir pour concevoir des TP en datascience
– Construire un parcours selon les besoins exprimés
– Proposer des cas d’application concrets pour projeter un TP dans le métier (former par le faire)
– Adapter en continu les modules selon les retours des bénéficiaires
– Installer une régularité des sessions de travaux pratiques et les animer en présentiel
– Permettre les échanges informels et l’entraide au sein de la communauté