Actualités & Datastories
Datastory #5 – Déploiement d’une infrastructure opensource

30/10/2023
1. Les infrastructures de DATAFID : un défi logistique et organisationnel
L’un des objectifs de DATAFID est d’encourager la pratique de la science des données dans les administrations fiscales et douanières, dans le but d’améliorer les performances de ces dernières. La première action du projet, dès 2022, a constitué en l’identification de cas d’usage lors d’un atelier régional organisé au Togo. Les cas d’usage sont des situations problématiques dont la solution peut passer par la mobilisation de la science des données vient résoudre un problème rencontré. Lors de cet atelier, les partenaires ont mentionné des situations souvent liées à l’analyse-risque ou des besoin en matière d’automatisation de certaines tâches redondantes et chronophages. Lorsque les équipes DATAFID se sont rendues dans les pays pour travailler sur ces sujets, elles se sont heurtées à une réalité qu’elles n’avaient pas anticipée : les administrations partenaires manquaient d’outils et d’infrastructures pour stocker les données, s’entraîner à leur manipulation, et les faire circuler , condition nécessaire à la réussite du projet.
Plusieurs questions se sont alors posées : faut-il se procurer des serveurs et les installer directement au sein des départements SI des administrations ? Comment gérer les enjeux de souveraineté et de sécurité liés aux données et informations ? Comment dimensionner les besoins en puissance de calcul, comment être surs que les infrastructures/outils seront vraiment utilisés ? Comment faciliter la documentation technique des projets réalisés ?
En confrontant ces questions aux contraintes du projet DATAFID, les équipes ont conclu qu’il n’était pas opportun de s’engager dans la fournitures de machines (serveurs, machines virtuelles) pour chaque pays tant que les besoins en manipulation de données (nos fameux cas d’usages) et en montées en compétences (nos fameux TP et formations) n’étaient pas suffisamment identifiés. L’alternative : préférer une approche simple, pratique, permettant aux équipes de s’exercer à des techniques nouvelles et d’explorer le potentiel de leurs données pour montrer des résultats avant de décider d’un système plus industriel.
2. L’open source, un atout pour concevoir une infrastructure évolutive
Depuis 2020, une équipe d’entrepreneurs d’intérêt général de l’Institut national de la statistique et des études économiques (Insee – France) développe Onyxia, une plateforme open source qui offre un environnement de travail autonome pour des datascientists et statisticiens. Cette plateforme comprend un catalogue de services de datascience, la possibilité de stocker des données de manière flexible et l’accès à une communauté. Une forme de salle d’entraînement, ou de “bac à sable” qui permet d’utiliser des librairies de datascience (en R et Python) pour traiter de la donnée sans se préoccuper des enjeux liés à l’infrastructure (serveurs, puissance de calculs, etc.).
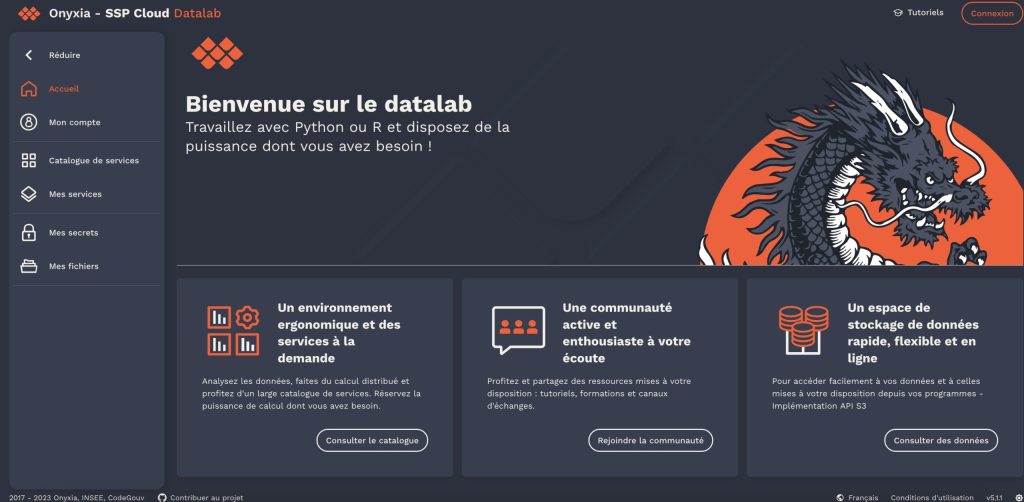
L’avantage : cette plateforme est open source, autrement dit le code et les éléments développés sont réutilisables, voire adaptables par tous. Ayant suivi de près le développement de ce projet, et après une phase d’expérimentation avec les équipes du projet, les experts DATAFID ont décidé d’adapter Onyxia à leurs besoins, en prenant en considération plusieurs principes :
- Commencer par une instance mutualisée à l’ensemble des pays partenaires afin de tester les usages et identifier ensuite les besoins spécifiques en traitement de données
- Prendre en compte les enjeux de sécurisation des données et éviter la fuite des données sources
- Favoriser l’acquisition de compétences et le partage de connaissances
La première version du datalab a donc été lancée sur des serveurs en France en juin 2022. Six services ont été proposés, issus des briques essentielles d’Onyxia, créés par les experts DATAFID et partagés par les partenaires du projet, notamment l’Organisation mondiale des douanes.
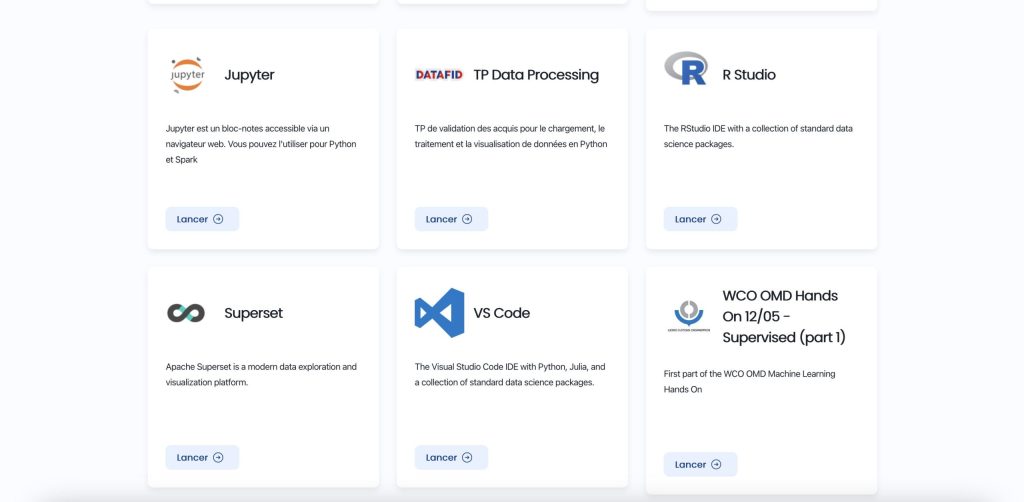
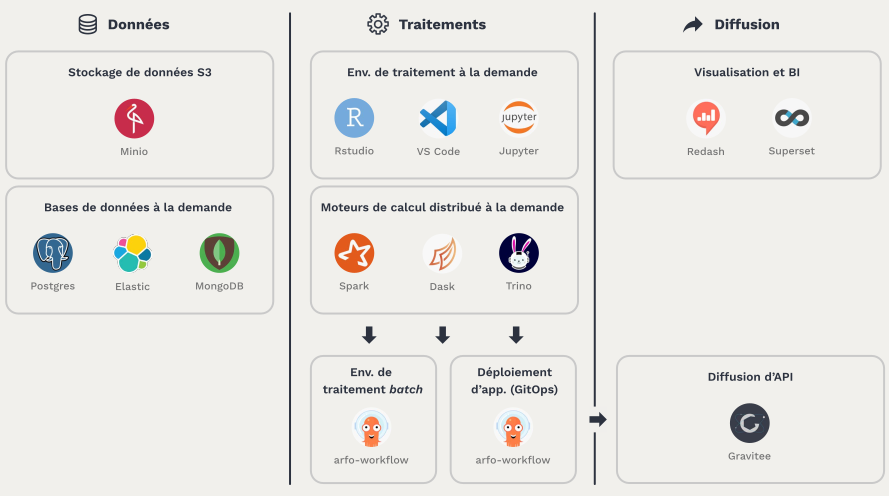
💡 Description de quelques services socles accessibles depuis le datalab, issus des briques essentielles d’Onyxia
Jupyter Notebook : Jupyter est un outil accessible via un navigateur web, permettant notamment d’écrire et d’exécuter des scripts Python ou R au sein de documents.
R Studio : R Studio est le plus célèbre environnement de développement dédié au langage R. Les instances déployées sur le Datalab permettent d’importer des jeux de données (depuis un CSV local, un Minio, une base de données distante…) et de développer des scripts R pour les analyser.
Apache Superset : Superset est un outil de datavisualization (dataviz). Les utilisateurs du Datalab peuvent exécuter une instance de Superset, y importer des données et créer divers graphiques et tableaux de bord.
Visual Studio (VS) Code : environnement de développement très populaire chez les développeurs, nous permettons aux utilisateurs du Datalab d’exécuter une instance en ligne de cet éditeur, au sein duquel ils peuvent exécuter des scripts Python, R…
Nous avons personnalisé cette première version progressivement, en y ajoutant ou renforçant des composants et mécanismes, parmi lesquels :
- Un composant open-source d’ETL (Extract Transform Load) : la structure des bases de données de certaines administrations partenaires est parfois ancienne et peu adaptée aux logiciels modernes de traitement des données. Par exemple, les bases de données de Sydonia (système d’information des douanes) sont basées sur une version dont le support date de 2011. Or, les langages et librairies de traitement de données ont fortement évolué depuis, rendant indispensable un connecteur : l’ETL. Il permet d’extraire des données à partir d’une véritable base de données en production, de les transformer et les adapter aux langages et librairies utilisées dans le datalab.
- Un mécanisme de “conteneurisation” avec Kubernetes (ou K8S dans le langage technique) : déjà intégré dans la logique d’Onyxia, il s’agit d’un système permettant d’automatiser l’infrastructure et lancer simultanément des machines virtuelles, ou conteneurs (dockers), qui agissent comme des ordinateurs indépendants et permettent ainsi à plusieurs personnes (voire un grand nombre) de travailler simultanément. Les opérations courantes d’accès, de maintenance et de démarrage des serveurs ne sont plus nécessaires, offrant ainsi un libre-service. Aucun serveur n’est surchargé et si une défaillance survient sur un serveur, l’anomalie est détectée et un redéploiement des conteneurs peut être assuré sans perte de données (en conformité avec les standards d’architecture big data). Des systèmes “d’étanchéisation” ont été prévus pour assurer la sécurité des données chargées sur le datalab.
- La possibilité de partager les résultats des travaux réalisés sur le datalab : c’est toute l’utilité des datastories ici présentées !
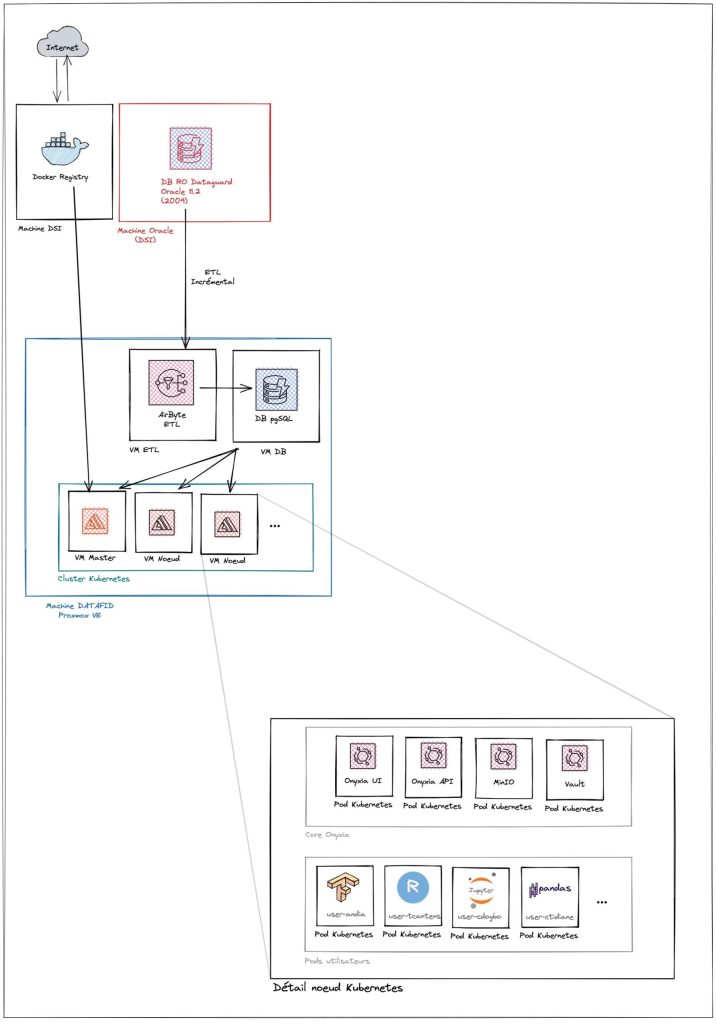
💡 Récapitulatif du parcours de la donnée dans l’infrastructure du datalab DATAFID (version simplifiée)
Définition des sources de données selon les besoins métiers (système d’information des douanes Sydonia, administrations fiscales, etc.)
Connexion et récupération de l’information (ETL)
Lancement des traitements d’analyses des données, en temps réel ou alors en temps différé (K8S et mise en place de conteneurs Docker)
Visualisation des données (avec utilisation d’outils tel que Superset) permettant la réalisation de travaux pratiques ou alors l’analyse de données pour des contrôles douaniers ou fiscaux.
<hé>3. Le datalab, la plateforme d’une communauté DATAFID grandissante aux usages sans cesse renouvelés</hé>
La plateforme a été rapidement testée auprès des administrations partenaires, et en premier lieu avec les douaniers ivoiriens et nigériens, ainsi que des membres de la DGI ivoirienne. Les besoins d’évolution et d’amélioration ont été remontés directement du terrain. Depuis son lancement, le datalab de DATAFID est devenue la pierre angulaire du projet, dans toutes ses dimensions.
Le datalab, un outil pour la conception et l’animation des TP
Les services de dataprocessing et des modules de formation issus du SSPLab-Onyxia se sont rapidement révélés utiles pour réaliser des études rapides sur les données et identifier les compétences à acquérir. C’est de cette manière qu’est née notre idée de réaliser des sessions de travaux pratiques (voir datastory dédiée).
Le datalab, un outil pour animer la communauté DATAFID
Sur les 6 derniers mois, nous comptons plus de 2 000 visiteurs uniques, près de 50 services, TP et formations disponibles, dont une dizaine qui ont été créés et ajoutés par l’équipe d’experts et des partenaires du projet, en premier lieu l’Organisation Mondiale des Douanes auprès de qui plusieurs démonstrations de la plateforme ont été réalisées.
Pour Clément Dupont, chef du projet DATAFID chez Expertise France, le datalab permet non seulement d’animer la communauté DATAFID mais aussi de créer une communauté d’acteurs autour d’Onyxia : “Face à des situations où certaines administrations optent pour des logiciels payants, nous avons pris le parti de proposer une solution gratuite et opensource. Ce n’est pas une solution miracle mais pour une initiation, et c’est l’objectif du projet, on n’a pas mieux. Le seul inconvénient réside dans le coût d’entrée pour la prise en main, mais nous sommes là pour les rendre autonomes sur ce sujet. Il est intéressant pour nous de voir que d’autres pays et d’autres structures comprennent l’intérêt d’adopter cet outil développé par l’INSEE. Le projet DATAFID participe à la création de cet écosystème autour d’Onyxia, véritable commun numérique !”
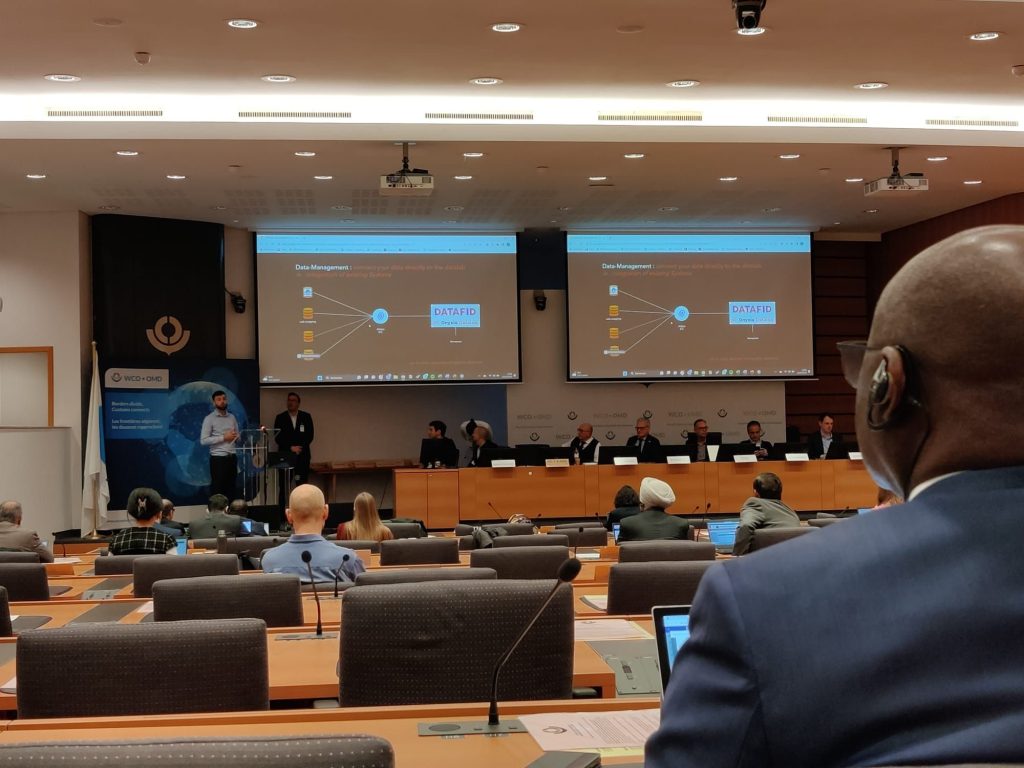
Le datalab, un outil en ligne… et une version installée en Côte d’Ivoire à l’automne 2023
Aujourd’hui, le datalab connaît une croissance importante. Après plusieurs mois d’utilisation, une instance locale a été installée en Côte d’Ivoire. Une documentation complète a été réalisée pour faciliter l’installation et la prise en main du datalab RCI, la gestion des rôles et des utilisateurs et l’utilisation des différentes briques.
“Le datalab a été déployé en Côte d’Ivoire, au sein du système d’information de l’administration douanière, et à la demande de cette dernière. Auparavant, la version du datalab utilisée par la douane était hébergée en France et les utilisateurs étaient obligés d’anonymiser leurs données pour respecter leur confidentialité, une tâche technique et chronophage, bien que nécessaire. L’installation sur place permet de pouvoir sur les données de façon plus directe. Les autres partenaires continuent d’utiliser la version hébergée en France et nous les accompagnons dans l’anonymisation des données. Mais un déploiement en local pourrait être aussi envisagé ailleurs, au profit des administrations qui en feraient la demande.” Clément Dupont, chef de projet DATAFID, Expertise France
A noter que la version en ligne reste disponible pour les pays partenaires.
Le datalab, un outil qui s’adapte aux nouvelles technologies !
Les prochaines étapes ? Enrichir encore et toujours les services du datalab, avec des modules liés notamment à l’intelligence artificielle générative, et bien sûr assurer l’autonomie des pays sur la plateforme.
En octobre 2023, lors d’un atelier sur l’Intelligence Artificielle Générative organisé à Clermont Ferrand par la Fondation pour les Etudes et Recherches en Développement International (FERDI), les experts de DATAFID ont annoncé le déploiement sur le datalab de Zephyr. Il s’agit d’une intelligence artificielle générative libre (licence MIT) que nous avons mise à disposition des pays partenaires afin de faire de la R&D sans que les données douanières et fiscales soient envoyées sur des plateformes propriétaires hébergées à l’étranger. Les datascientists peuvent d’ores et déjà apprivoiser ce grand modèle de langage (LLM). Zéphyr permettra ultérieurement de faire tourner des applications déjà existantes comme par exemple PandasAI ou toutes autres applications de datascience semi-automatisées.
Vous êtes intéressés par le datalab et ses fonctionnalités. Écrivez-nous à !