Actualités & Datastories
Datastory #7 – Analyses miroir : comparer des données douanières internationales standardisées pour identifier des anomalies

23/12/2023
2. L’harmonisation des données douanières à l’international, clef de voute pour détecter des risques de fraude par glissement tarifaire grâce aux analyses miroir
Les contrôles douaniers sont une matière particulièrement prône à l’automatisation et au pilotage par la donnée, et ce pour plusieurs raisons.
La majorité des États du monde ont en grande partie informatisé leurs procédures, en mettant en place des systèmes d’information dédiés. C’est le cas de la Côte d’Ivoire qui, comme 102 pays ou territoires, utilise le logiciel SYDONIA développé par la CNUCED (Conférence des Nations Unies sur le commerce et le développement). En utilisant de tels systèmes d’information, on s’assure que la donnée collectée (déclarations en douane, enquêtes menées…) est stockée et traitée de façon homogène d’un pays à l’autre, facilitant ainsi l’analyse a posteriori et les comparaisons entre États.
Pour en savoir plus sur le logiciel SYDONIA, n’hésitez pas à consulter la datastory #6 sur le sujet
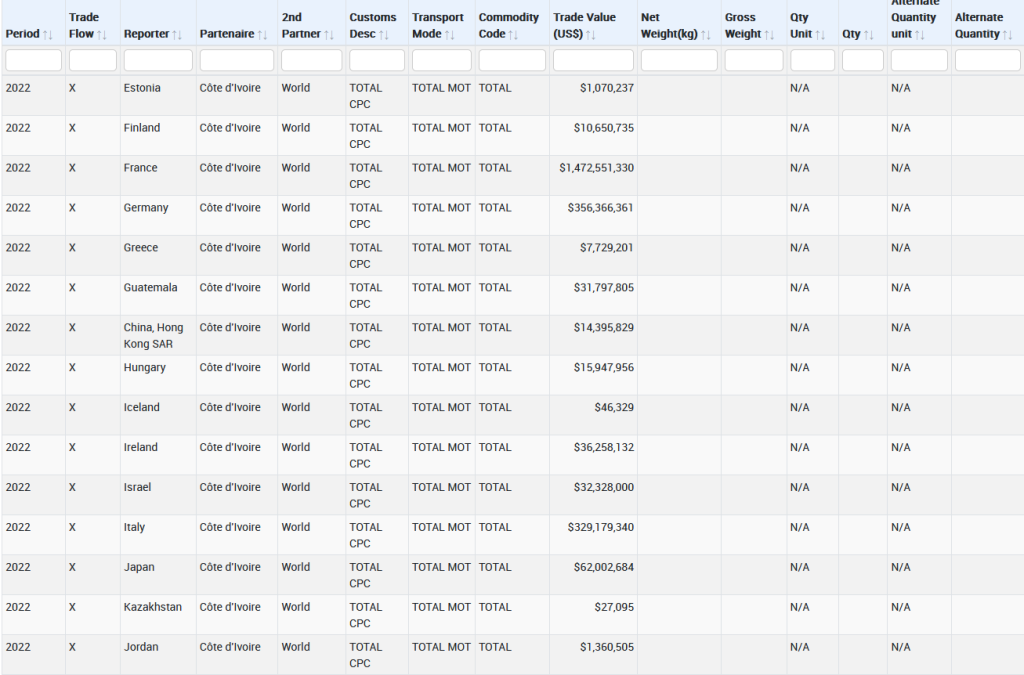
Ensuite, il existe une base de données internationale du commerce mondial appelée Comtrade, compilée par la division Statistiques de l’ONU, qui centralise des données de 200 pays. Elle propose un répertoire complet des échanges de marchandises à l’échelle mondiale, une ressource très précieuse pour les organisations douanières.
❓ Les codes SH
Le code SH, composé de 10 chiffres, permet de caractériser une marchandise avec une grande précision. Chaque chiffre du code correspond à une caractéristique spécifique de la marchandise. Plus le code SH est détaillé, plus les informations sur la nature de la marchandise sont précises. On désigne un code SH par le nombre de chiffres qu’il contient. Prenons l’exemple du code SH10 0304870010 : pour comprendre de quelle marchandise il s’agit, on peut le décomposer par blocs de deux chiffres, représentant une catégorisation de plus en plus précise.
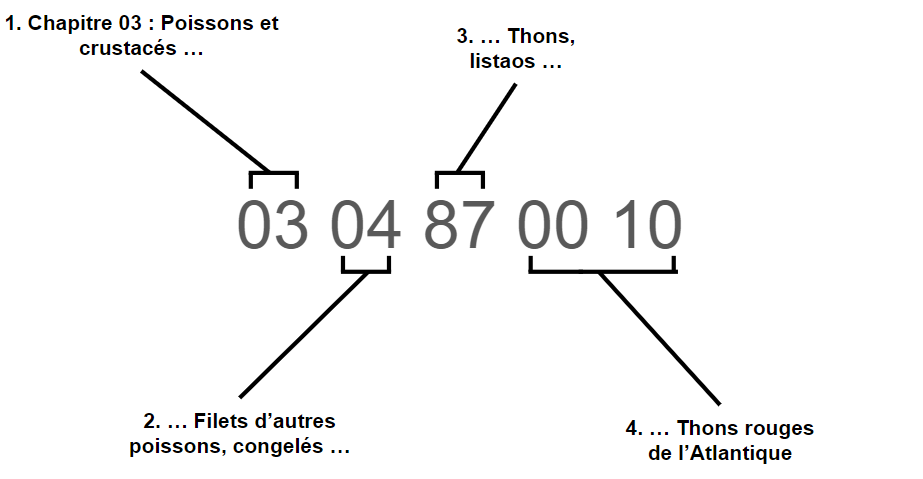
Dans 183 pays, les six premiers chiffres sont identiques, tandis que les chiffres restants sont généralement spécifiques à chaque pays et déterminent les taux d’imposition ou les taux préférentiels applicables. La base Comtrade s’arrête à 6 chiffres (on parle de SH6) et son usage peut donc entraîner une perte ou dilution d’informations. Chaque pays est libre d’affiner le modèle au-delà de ce sixième chiffre en fonction de ses propres préférences et contraintes, ce qui peut entraîner une variabilité dans la quantité d’information recueillie. Néanmoins, le niveau de précision des codes SH6 offre une grille de lecture suffisamment fine pour permettre une première analyse assez approfondie.
Pour plus d’informations sur le système SH, vous pouvez vous reporter à la data story #2 sur la loi de Benford
En conclusion, l’usage d’un Système d’Information harmonisé, la centralisation des données dans une base globale, et l’utilisation d’une nomenclature commune (codes SH) sont autant d’éléments offrant des perspectives intéressantes en matière d’utilisation de science des données. Parmi elles figure la possibilité de mener des analyses-miroir sur les différentes positions tarifaires. L’exercice consiste à calculer puis examiner les écarts observés entre les déclarations d’exportation du monde entier vers un pays donné, et les importations enregistrées par ce pays.
🔧 La « position tarifaire« , c’est l’alignement entre le code SH (Système Harmonisé) et la taxation qui lui est associée. Essentiellement, la position tarifaire peut varier principalement en fonction des valeurs premières du groupe SH. Par exemple, la taxation d’un ordinateur ne diffère pas en fonction de sa marque, que ce soit Intel ou HP.
3. Les analyses miroir, une approche fondée sur l’analyse d’écarts pour lutter contre la fraude par glissement tarifaire
Lorsqu’une marchandise est transportée vers la Côte d’Ivoire, l’importateur a du procéder à deux déclarations en douane de sa marchandise : une fois à l’export, et une fois à l’import. Certains importateurs tentent néanmoins de contourner le système, en choisissant des positions tarifaires différentes pour une même marchandise. Une analyse miroir doit permettre de comparer, au global, ces deux déclarations pour une marchandise donnée, en termes de valeur et de volume déclaré. Si tout va bien, on observera une concordance quasi-parfaite (de très légers écarts s’expliquent souvent par des taux de change approximatifs entre les monnaies, par exemple). En revanche, si tous les pays du monde ont déclaré qu’un total de 100 tonnes d’abats de poulet a été exporté vers la Côte d’Ivoire mais que le volume des importations d’abats de poulet du pays retrouvé dans les données ivoiriennes est largement supérieur, on peut suspecter une fraude. Il conviendra donc de mener des enquêtes plus approfondies.
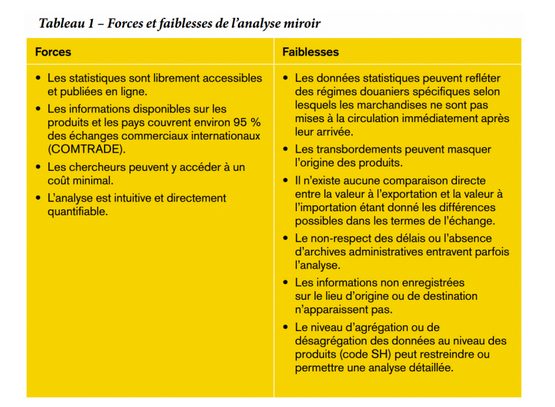
L’analyse miroir permet des éclairages sur certaines dynamiques, même s’il convient de garder à l’esprit certaines de ses limites, comme le montre le tableau ci-dessous.
En Côte d’Ivoire, la Direction Générale des Douanes a mis en place un dispositif technique et institutionnel pour la production d’analyses miroir.
Une Cellule d’Analyse des Données Miroirs (CADOM), censée se réunir tous les mois, comprend des représentants de la DARRV et de la DSEE. La DSEE doit calculer les écarts miroir et propose des pistes d’analyse à la DARRV, et cette dernière compile un rapport avec des hypothèses qu’elle soumet au Comité de Gestion des Données Miroirs (COGESDOM), composé de Directeurs de directions concernées (DARRV, Direction des Enquêtes Douanières, président du Comité de réforme). Le COGESDOM étudie les analyses de la CADOM et prend un certain nombre de décisions en conséquence : mise à jour du modèle de sélectivité, orientation des enquêtes, etc.
Théoriquement fonctionnel, ce dispositif souffre cependant de plusieurs problèmes. D’abord, les analyses de la DSEE sont réalisées en récupérant manuellement les données des bases mentionnées ci-dessus. Ce travail était particulièrement chronophage et les empêchait de traiter plus d’une vingtaines de positions tarifaires chaque année. Ensuite, ces analyses sont envoyées en format Word ou PDF à la DARRV, cette dernière étant alors en charge de produire les hypothèses pouvant expliquer les résultats des analyses. Dans cette phase, les Directions travaillent de façon relativement isolée. Les données communiquées par la DSEE sont exploitées en l’état par la DARRV, et les éventuelles demandes de complément d’information passent par des courriers dont la transmission et le traitement sont chronophages et peu efficients. En outre, la DSEE n’est pas informée du contenu des rapports de la CADOM vers le COGESDOM et n’a pas de vision du traitement qui est fait des analyses qu’elle propose. Du fait du temps passé à la production de ces études, et du manque de partage et de croisement d’information lors de la phase d’analyse, les analyses miroir produites par la DGD de la RCI ne parviennent pas à pleinement réaliser leur potentiel.
L’accompagnement proposé par DATAFID s’est attelé à résoudre ces deux problèmes : automatiser au maximum le travail d’analyse, et proposer une méthode qui permette collectivement de valider ou écarter des hypothèses quant aux raisons des anomalies constatées.
4. L’accompagnement de DATAFID : tirer partie de travaux d’automatisation et de visualisation de données pour améliorer la qualité des analyses miroirs et guider le travail collectif
En novembre 2023, les experts DATAFID ont travaillé avec un statisticien de la DSEE à l’automatisation de l’analyse des données, en co-construisant un script Python qui agrège les données relatives aux marchandises importées en Côte d’Ivoire et exportées vers la Côte d’Ivoire (données respectivement issues de SYDONIA et de Comtrade). L’agrégation est rendue possible par le système harmonisé (SH), qui permet de comparer sur une seule ligne les informations relatives à une marchandise spécifique, pays par pays et au global, sur l’année 2021 (la base Comtrade ne permettant l’accès qu’aux données de l’année N-2).
Une fois ces informations agrégées, nous avons proposé une data visualisation pour faciliter l’appréhension des données, avec un premier exemple de tableau de bord. Il offre une vision globale des écarts constatés entre les déclarations faites à l’export (aux douanes d’autres pays) et à l’import (en douane ivoirienne), selon deux critères : le volume et la valeur. Un système de filtres permet ensuite d’affiner les observations sur des pays spécifiques, ou au contraire d’élargir la vision en observant un chapitre SH2 ou SH4 plutôt qu’un unique code SH6.
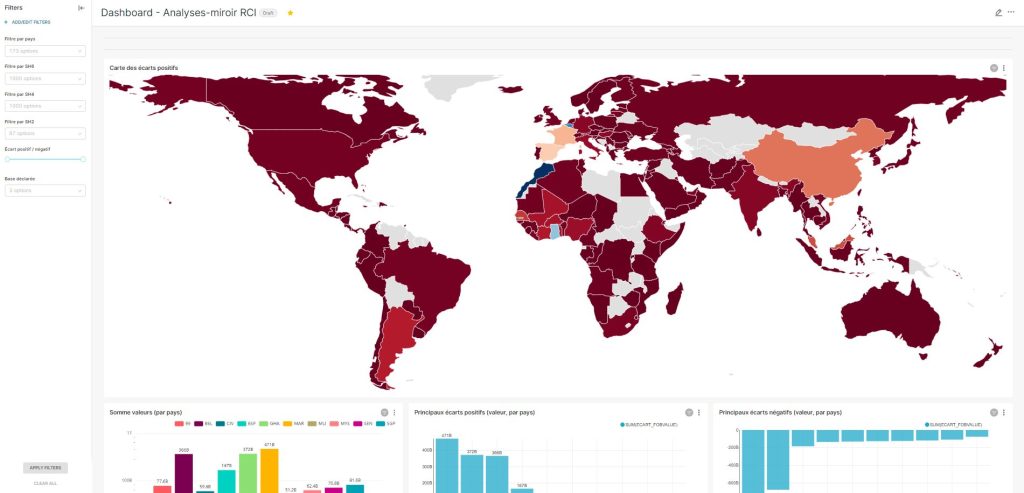
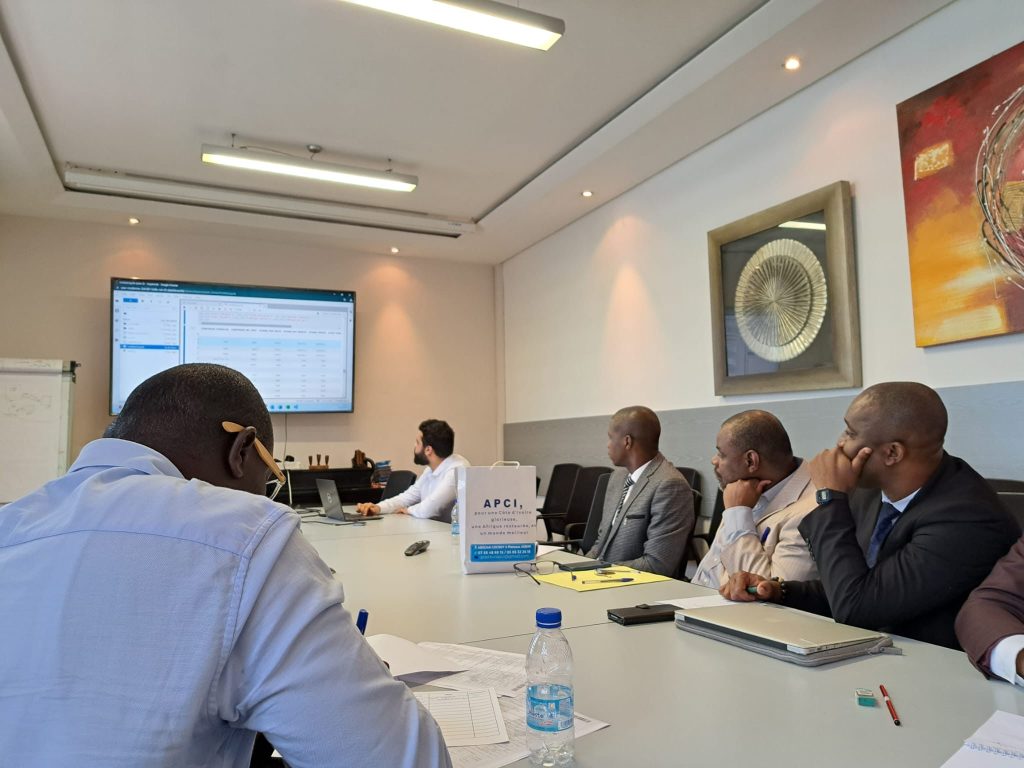
Ensuite, en lieu et place du traditionnel rapport Word ou PDF de la DSEE vers la DARRV, nous avons proposé une séance commune d’analyse des écarts observés avec des Directions présentant de fortes connaissances métier (DARRV, mais aussi la Direction des Enquêtes Douanières) avec possibilité de manipuler les données en direct et d’ainsi explorer les hypothèses formulées. Leur présence a dans un premier temps permis de proposer une explication “rationnelle” à certaines anomalies constatées par la DSEE, auparavant considérées comme posant un risque de fraude.
Lors de cette séance, plusieurs écarts ont été discutés :
- Des écarts ont été constatés sur des marchandises de types fruits ou légumes en provenance de pays dans la sous-région. Néanmoins, ces biens n’étant pas soumis à des droits de douane, la possibilité d’une fraude fiscale a pu être écartée, et les raisons de ces écarts semblent davantage être un problème de qualité de données
- Les données relatives à certains types d’antennes satellites importées pouvaient laisser supposer un risque de fraude. En réalité, la connaissance de la DARRV a permis d’établir que ces produits faisaient l’objet d’exemptions fiscales, ce que l’agrégation des données Comtrade et Sydonia ne permettait pas de noter.
En revanche, une fois ces “fausses” anomalies écartées, l’exercice a permis d’identifier de réels cas de glissements tarifaires, c’est à dire des situations de modification du code SH d’une marchandise par un code SH proche, aux fins de bénéficier d’un régime de droits de douanes amoindri. Pour des raisons de confidentialité, ils ne peuvent être exposés ici, mais ont fait l’objet de discussions lors de la séance et feront l’objet d’investigation par les services compétents de la douane.
En quelques heures, plusieurs éléments ont été relevés par les directions :
- L’utilité de ce travail en séance, jamais réalisé jusqu’alors : le script et la data visualization l’accompagnant ont surtout servi de “prétexte” à la transformation, en vue de faciliter la prise de décision relative aux suites à donner en cas d’anomalies. Jusqu’alors, la DSEE remontait tous les écarts les plus importants à la DARRV et à la DED, alors qu’une partie d’entre eux ont trouvé une explication par la simple réunion dans une même pièce des trois directions concernées par l’analyse de risque pendant une demi-journée pour discuter des résultats observés.
- Des problèmes de qualité des données, sur lesquels les douanes ivoiriennes devront se pencher au cours des prochains mois : plus une organisation fait usage de la donnée pour son pilotage, plus il est important qu’elle porte une attention particulière à sa qualité.
Cette co-production offre un cadre d’échanges solide aux douanes ivoiriennes. Dans un certain nombre de cas, la connaissance métier d’un des services permettra d’expliquer un écart important, qui serait donc légitime et non consécutif à une fraude. Les différentes directions pourront alors se concentrer sur les anomalies avérées, et se mettre d’accord sur les enquêtes à mener et la mise en place d’une surveillance plus importante sur certaines marchandises.
5. Et après ?
Ce travail avait pour but de rendre plus efficient le calcul des écarts (automatisation) et d’améliorer la qualité des analyses proposées (création d’une data visualisation et possibilité de manipuler les données en direct).
L’agrégation des bases de données nécessite toujours de s’intéresser de près à la construction de leurs tables, afin de coordonner des variables et des champs sur une base commune. En d’autres termes, les mettre au même format, ce qui n’est pas toujours le cas par défaut. En l’état actuel, le script récupère les données Comtrade via son API, et les données de SYDONIA en lisant un export CSV préparé au préalable. L’objectif est désormais de récupérer les données en se connectant directement à SYDONIA, et de rendre le script plus modulable quant aux années ou aux marchandises.
Au niveau organisationnel, ces nouveaux outils d’analyses-miroir ont permis aux 3 directions d’expérimenter une nouvelle manière de collaborer, se réunissant pour travailler ensemble à l’analyse des données.
L’exercice sera reproduit à l’avenir, sur des jeux de données plus récents. Il sera alors intéressant de comparer les données d’une année sur l’autre, et d’étudier les écarts dans le temps. Il conviendra également que la DSEE, la DARRV et la DED travaillent sur ces analyses-miroir sur une plus longue durée pour une étude plus exhaustive, cette première séance d’une demi-journée n’ayant permis de se focaliser que sur quelques catégories de marchandises. Elles pourront par ailleurs y associer d’autres directions, qui apporteront leur propre savoir métier. Un dernier aspect, relevé par les participants, tient à la consolidation de la connaissance partagée. Il est ainsi envisagé de créer une base de données, agrégeant les différents éléments pouvant expliquer les écarts tel ou tel code SH, afin de simplifier ce travail au fil du temps.